跳到主要内容 点滴安全 滴水穿石,安全致远
专注 AI 安全与网络安全的独立技术社区。
人工审核 · 可溯源资料 · 不采集广告 PII
点滴安全 滴水穿石,安全致远
专注 AI 安全与网络安全的独立技术社区。
人工审核 · 可溯源资料 · 不采集广告 PII
华为昇腾全系列芯片深度研究报告:架构、软件栈、竞品与产业落地(2026-11) | 点滴安全
首页 … 博客 AI 安全 华为昇腾全系列芯片深度研究报告:架构、软件栈、竞品与产业落地(2026-11)
华为昇腾全系列芯片深度研究报告:架构、软件栈、竞品与产业落地(2026-11) 基于公开信息与独立分析,系统梳理昇腾 310/610/910/950/960/970 全系芯片、CANN/MindSpore 软件栈、CloudMatrix 与 Atlas 超节点、与英伟达等竞品的对比及产业落地,并给出 2026–2028 趋势判断与风险清单。
1 理解「摘要」的关键结论与适用边界 2 理解「十条核心判断」的关键结论与适用边界 3 理解「第一章 研究范围、方法与口径说明」的关键结论与适用边界
点
点小安 | 2026年11月10日
编者按 :本文由点滴安全基于截至 2026 年 11 月 10 日 的公开信息整理与独立分析,非华为官方发布。文中所有数据均尽量标注来源与口径;涉及未公开的制程、良率、产能与财务数据仅作定性判断并明确标注"未证实"。图表由本站依据报告引用数据自行绘制,不复制任何第三方图片 。本文不构成投资建议,引用数据时请保留"单卡/系统""稠密/稀疏""官方/第三方"等限定词。
摘要
昇腾是华为面向 AI 计算的统一芯片品牌,自 2018 年昇腾 310 起步,已形成"边缘推理 310 系—车规 610—云端训练 910 系—新一代 950/960/970"四条产品线。截至 2026 年 11 月,产业格局可以概括为:单卡受制程约束仍落后国际旗舰 1–3 倍,但华为用"超节点 + 灵衢互联 + 光通信"把竞争维度搬到系统级,在规模、内存池与互联带宽上实现了局部反超,代价是更高的功耗与更年轻的软件生态。
十条核心判断
本报告的核心结论如下:
架构主线清晰 。达芬奇(Da Vinci)架构以 16×16×16 的 3D Cube 为算力核心(单周期 4096 次 MAC),配 Vector、Scalar、AI CPU 与分级片上存储;910B 起 Cube/Vector 分离(AIC/AIV 1∶2),950 起转向 SIMD/SIMT 混合并取消 4∶2 稀疏,架构在向"更通用、更易编程"演进 [16][28]。910C 是当前量产主力 。双 die 合封,官方口径 FP16 800 TFLOPS、HBM 128 GB / 3.2 TB/s、互联 784 GB/s;由 384 颗 910C 组成的 CloudMatrix 384 系统级稠密 BF16 约 300 PFLOPS,第三方评估为 GB200 NVL72 的约 2 倍 [1][14][15][27]。950 代际的关键不是纯算力,而是"低精度 + 自研 HBM + 互联" 。950PR/950DT 支持 FP8/MXFP8/HiF8/MXFP4,FP8 1 PFLOPS、MXFP4 2 PFLOPS,互联 2 TB/s;首次导入自研 HBM(HiBL 1.0 / HiZQ 2.0),分别面向 Prefill/推荐与 Decode/训练 [1][2][18]。2026 年的真实节奏是"如期但缩配" 。950PR 于 2026 年 Q1 上市但"量不算大";搭载 950PR 的 Atlas 350 标卡于 3 月上市(112 GB HBM、FP4 1.56 PFLOPS、600 W);950DT 超节点"测试中,年底至明年初规模供货";首批 950 超节点以 1024 卡形态交付,8192 卡满配属"技术可达、按需配置" [23][24][25][21]。
继续系统学习 把本文知识点放进学习路径,按阶段继续实践。
原创声明: 本文为「点滴安全」原创内容,版权归原作者所有。转载请注明来源「点滴安全」并保留原文链接。免责声明
系统级指标已进入"世界第一梯队"叙事 。Atlas 950 SuperPoD 满配 8192 卡、FP8 8 EFLOPS / FP4 16 EFLOPS、内存 1152 TB、互联 16.3 PB/s;Atlas 950 SuperCluster 规划 50 万卡以上;2026 年 9 月又发布全球首个 NPO 超节点"昇腾 960 超节点"(4096 卡、FP8 8 EFLOPS、2027 年 Q3 上市)[1][3][20]。
软件栈完成"从自研到开源"的转身,但成色需打折 。CANN 从 1.0(2018)迭代至 9.2(2026 年 10 月),2025 年 8 月宣布开源、2025 年底完成上仓,代码托管于 GitCode/AtomGit;但许可证限定"仅用于华为 AI 处理器"、可撤销、不可再授权,不满足 OSI 开源定义 [4][7][9][29][30]。
框架生态"双轨"成型 。MindSpore 稳定在 2.x(最新 2.8,2026-01);PyTorch 由 TorchNPU 承载,26.1.0 单树支持 PyTorch 2.7.1–2.12;推理侧 vLLM-Ascend 与上游 main2main 对齐,2026-10 发布 v0.30.0 [10][11][12][13]。
迁移成本接近"换一门语言"而非"改一行代码" 。图模式才是昇腾主场,算子级需 Ascend C 重写;社区实测记录了 FP8 训练缺失、训推精度不一致、CUDA Graph 不支持等硬边界 [31][32]。
产业落地已"基础设施化" 。三大运营商与"东数西算"枢纽是最大买方(中国移动三集群近 6 万卡);工行、南网、科大讯飞等进入核心业务。2025 年中国 AI 加速卡出货约 400 万张,国产占 41%、华为 81.2 万张约 20%;2026 年上半年华为升至约 28.5%,与英伟达仅差 6 个百分点 [34][35][38][39][42][44][46]。
未来 18 个月的关键变量是供给而非架构 。先进制程良率、自研 HBM 爬坡、光模块与液冷供给决定 950 系列能交多少;HBM 短缺已推动 950DT 涨至逾 25 万元、较两个月前上涨 20%–50%。昇腾在中国推理市场的主导地位趋于确立,训练侧能否替代英伟达,取决于 950DT 的实际交付量与万卡 MFU 的可验证数据 [49][54][55]。
第一章 研究范围、方法与口径说明
1.1 研究范围 本报告覆盖昇腾全系列 AI 芯片(310/310P/310B、610、910A/910B/910C/910D、950PR/950DT、960、970)及其板卡、整机、超节点与集群形态,同时覆盖支撑其运行的 CANN、MindSpore、MindIE、TorchNPU、vLLM-Ascend 等软件栈,并对标 NVIDIA、AMD、Google、AWS 与国内主要 AI 芯片厂商。信息来源限定为:华为官网与昇腾社区、合作整机厂商与上市公司公告、Hugging Face 与上游开源社区(vLLM、PyTorch、verl)、IDC/TrendForce/SemiAnalysis 等研究机构、路透/彭博/新华社/人民日报/财新等媒体。
1.2 为什么"口径"比数字更重要 AI 芯片对比中,同一颗芯片可以出现三四个相差数倍的"算力"。本报告在引用任何数字时,均尽量同时标注以下四个维度;读者在引用本报告时亦应保留这些限定词。
口径维度 常见陷阱 本报告处理方式 稠密 / 稀疏 英伟达 Blackwell 起的"20 PF FP4"为 2∶4 稀疏值,稠密为 9 PF;AMD MI355X 的 10 PF FP8 亦为稀疏 除特别说明,一律采用稠密 口径 [57][58][59] 芯片 / 板卡 / 系统 Atlas 950 的 8 EFLOPS 是 8192 颗芯片的系统值;GB300 NVL72 的 1.1 EF FP4 是 72 颗 GPU 的整机值 始终带"单卡/整机/集群"限定词 芯片本体功耗 / 板卡功耗 910C 芯片本体约 310 W,OAM 板卡约 600 W,相差近一倍 注明测量对象 [27] FP16 / BF16 / FP8 / FP4 昇腾官方路线图未标注稀疏,384×800 TFLOPS≈300 PF 可反证 910C 的 800 TFLOPS 为稠密 BF16/FP16 同速 训练看 BF16/FP8,推理看 FP8/FP4
1.3 来源分级与本报告的判断规则
A 类(一手官方) :华为新闻稿与演讲全文、昇腾社区产品文档、CANN/TorchNPU/vLLM-Ascend 版本说明、上市公司年报/公告。冲突时以 A 类为准。B 类(权威第三方) :IDC、TrendForce、SemiAnalysis、LightCounting、券商研报、央媒与主流财经媒体。用于交叉验证与系统级测算。C 类(社区/传闻) :开发者博客、论坛、自媒体、参数百科。仅用于提示"存在此说法",不单独作为事实依据。 明确的存疑清单 (正文相应位置会再次标注):① 950PR 与 950DT 的内存参数曾被多家媒体写反(本报告采用 PR=HiBL 1.0、DT=HiZQ 2.0);② 910B/910C 制程存在"中芯 N+2"与"SemiAnalysis 拆解为台积电 7 nm"两种说法;③ 910D 未进入官方路线图,所有规格均为传闻;④ Atlas 950 SuperPoD 首批交付"1024 卡"与"8192 卡满配"两种口径并存;⑤ 950PR 标卡 112 GB 与芯片 128 GB 的差异原因未获官方解释;⑥ 万卡 MFU 与"昇腾 vs 英伟达"全生命周期 TCO 均无公开可复现数据。
第二章 昇腾芯片谱系与架构演进
2.1 全景:四条产品线与五代架构 型号 发布/上市 定位 关键算力(口径) 内存 互联 典型功耗 主要应用场景 昇腾 310 2018-10 边缘推理 16 TOPS INT8(第三方口径) 板载 DDR/LPDDR PCIe 约 8 W(媒体口径) 智能摄像头、边缘盒子、Atlas 200 昇腾 310P 2021 推理主力 140 TOPS INT8(官方,单卡) 24 GB LPDDR4X(行业资料) PCIe 4.0 约 72 W(行业资料) 信创推理服务器、视频解析 昇腾 310B 2023 边缘/开发者 8 TOPS INT8 / 4 TFLOPS FP16(官方套件) LPDDR4X 4 GB PCIe 24 W(整机套件) 开发者套件、边缘 AI 昇腾 610 2020 前后 车规 MDC 160–200 TOPS INT8(第三方) 车规 LPDDR 车载以太网 车规级 智能驾驶域控(MDC 610/810) 昇腾 910A 2019-08 云端训练 FP16 256 TFLOPS / INT8 512 TOPS(官方) HBM2 32 GB(行业资料) HCCS 310 W 典型 / 350 W 最大(官方) 早期智算中心、训练集群 昇腾 910B1–B4 2023 训练/推理 FP16 约 320–414 TFLOPS(按核数推算) 64 GB HBM2e / 约 1.2–1.6 TB/s HCCS 7×28 GB/s 300–400 W(行业资料) Atlas 800T A2、Atlas 900 A2 昇腾 910C 2025-Q1 训练/推理主力 FP16 800 TFLOPS(官方,稠密) 128 GB HBM2e / 3.2 TB/s(官方) 784 GB/s(官方) 约 600 W(板卡)/310 W(芯片) CloudMatrix 384、Atlas 900 A3 昇腾 910D 未发布 传闻型号 320 TFLOPS–1.2 PFLOPS(传闻) 96–128 GB(传闻) 未披露 350–400 W(传闻) 不在官方路线图内,不应作为选型依据 昇腾 950PR 2026-Q1 推理 Prefill/推荐 FP8 1 PFLOPS;MXFP4 2 PFLOPS HiBL 1.0,128 GB / 1.6 TB/s 2 TB/s 未公开(Atlas 350 整卡 600 W) Atlas 350 标卡、950 超节点 昇腾 950DT 2026-Q4 推理 Decode/训练 FP8 1 PFLOPS;MXFP4 2 PFLOPS HiZQ 2.0,144 GB / 4 TB/s 2 TB/s 未公开 Atlas 950 SuperPoD 昇腾 960 2027-Q4(原规划) 训推旗舰 FP8 2 PFLOPS;FP4 4 PFLOPS;HiF4 288 GB / 9.6 TB/s 40 个互联端口 未公开 Atlas 960 SuperPoD 昇腾 970 2028-Q4 下一代旗舰 FP8 4 PFLOPS;FP4 8 PFLOPS 288 GB / 14.4 TB/s 4 TB/s 未公开 形态未公开
数据来源:310P/310B 为昇腾社区官方文档 [5][6];910A 为 2019 年发布会官方口径;910B/910C 的算力与内存综合官方路线图、CANN 工具链配置与第三方拆解 [1][27][28];950 及以后为 2025 年全联接大会官方路线图 [1][2][18]。
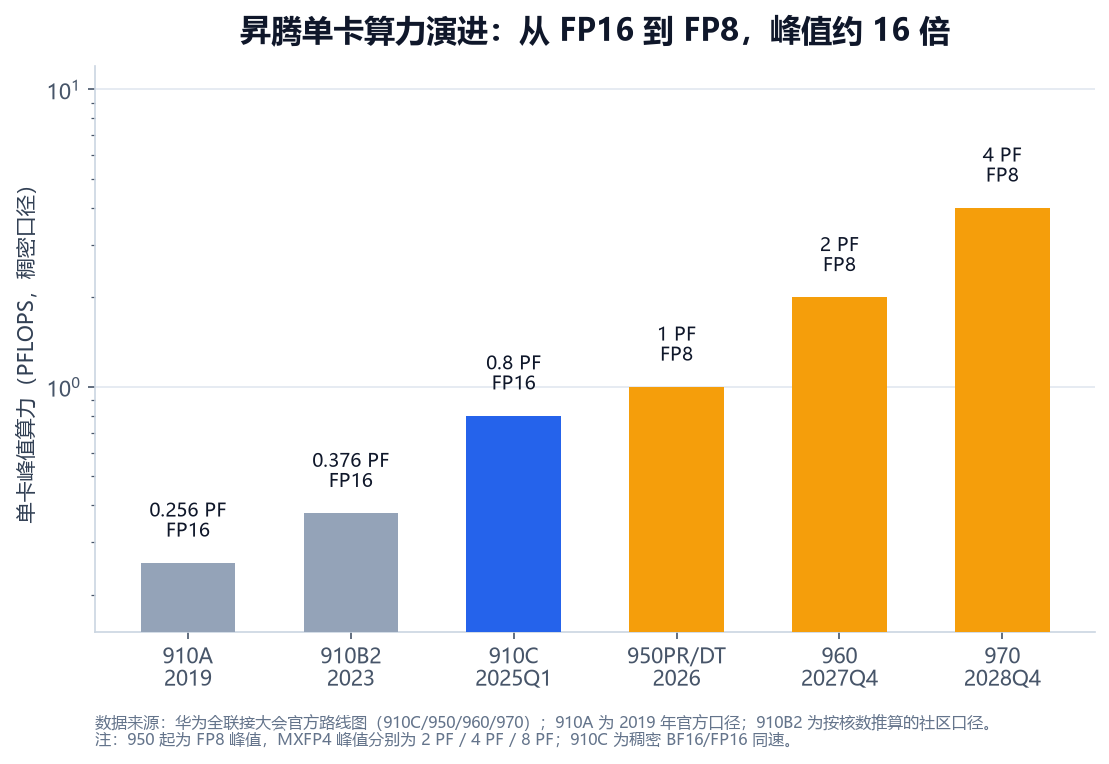
图 1 昇腾单卡算力演进(FP16 → FP8,峰值约 16 倍)。图表由点滴安全依据报告引用数据绘制。
2.2 达芬奇架构解剖 达芬奇架构的核心是 AI Core 内部标量(Scalar)、向量(Vector)、矩阵(Cube)三单元异构并行,配合搬运引擎与多级片上缓存构成"搬入—计算—搬出"流水 [28][31]。
Cube 单元 :三维 16×16×16 矩阵乘加阵列,单周期完成 4096 次 MAC(8192 次浮点运算),是昇腾算力的绝对主体,承担 MatMul、卷积等计算密集算子,输入支持 FP16/BF16、累加 FP32。Vector 单元 :承担激活、归一化、池化、逐元素运算等访存密集算子,支持 FP16/BF16/FP32/INT32。910B 起采用 AIC(Cube 核)与 AIV(Vector 核)分离 架构,二者无直连数据通道、交互经 L2 完成;核间比例为 1∶2(如 910B2 为 24 Cube + 48 Vector)。910A 则是 Cube 与 Vector 内聚于同一 AICore 的耦合模式。Scalar 单元与 AI CPU :前者负责指令译码、循环控制与地址计算;后者是 SoC 内独立的 ARM 通用核集群,承担控制密集型算子与框架适配。官方仅描述功能定位,未公开各型号 AI CPU 核数,网络流传的具体核数多属逆向推测,本报告不采信。存储层次 :GM(HBM)→L2→L1→L0A/L0B/L0C,外加统一缓冲(UB);MTE1/MTE2/MTE3 三类 DMA 引擎负责搬运,实现计算与访存重叠。以 910B2 为例:L1 512 KB、L0A/L0B 各 64 KB、L0C 128 KB、UB 192 KB [17]。 其一是 AIC/AIV 分离 (910B 起)。Cube 与 Vector 拆成独立核,便于流水并行与算子融合,但也带来核间同步与数据搬运开销,这是 CANN 图编译器大量做算子融合的直接动因。
其二是 SIMD/SIMT 混合 + 存储粒度细化 (950 起)。950 系列新增 SIMT 编程模型,与 SIMD 并存:SIMD 处理"大块"向量,SIMT 灵活处理碎片化数据;同时把内存访问颗粒度从 512 字节降到 128 字节,小算子访存效率提升约 4 倍。工具链层面 950 增加 SIMT Register File 128 KB、DCache 128 KB、每 AIV 4 个 Warp Scheduler、SSBuffer 256 KB,并出现 L0C→UB、UB→L1 的 CV 直通通路。架构含义:昇腾在向 GPU 式"更通用、更易编程"的执行模型靠拢,同时保留 Cube 的矩阵算力优势 [2][16]。
2.3 边缘与推理:310 系列 昇腾 310 是达芬奇架构的首发产品(2018 年),以 16 TOPS INT8 级别的算力与极低功耗(媒体口径约 8 W)打开了边缘推理市场。当前主力是 310P 与 310B:
昇腾 310P :Atlas 300I Pro 推理卡"采用 1 个昇腾 310P,最高提供 140 TOPS INT8",是信创推理服务器与视频解析的主流配卡;双芯版本 Atlas 300I Duo 在业内常按 280 TOPS INT8 估算(官方介绍页未列总算力)[5]。昇腾 310B :面向边缘与开发者。Atlas 200I DK A2 开发者套件官方规格为 8 TOPS INT8 / 4 TFLOPS FP16、LPDDR4X 4 GB(支持 ECC)、4 核 1.0 GHz CPU、典型功耗 24 W。架构上把 AICore/VectorCore/CubeCore 三合一集成于单核,UB 提升至 248 KB 并支持 4∶2 稀疏,属"小芯片、高集成"路线 [6][28]。 适用场景判断 :310 系列不适合任何大模型训练,也不适合高并发 LLM 推理;其真实价值在于视频结构化、工业质检、边缘多路视频分析与信创办公推理。Atlas 300I Duo 这类"多芯拼算力"的产品在 LLM 推理上受限于显存容量与带宽,2025 年后正被 910B/910C 推理服务器与 950PR 标卡替代。
2.4 车规:昇腾 610 昇腾 610 是 MDC 智能驾驶平台的主控 AI 芯片,通常与英飞凌 TC397 等安全 MCU 组合,构成"AI 计算 + 功能安全(ASIL-D)"架构;MDC 610 平台算力标称 160–200 TOPS(INT8 稠密,第三方口径)。需要强调:华为未公开 610 的完整数据表(制程、内存、功耗均无官方披露),7 nm 制程说法亦属第三方口径。若用于正式选型,应以 MDC 平台官方彩页为准。
2.5 云端训练:910A → 910B → 910C 910A(2019) :官方口径 FP16 256 TFLOPS、INT8 512 TOPS、典型功耗 310 W(最大 350 W),是昇腾首次在单芯片算力上对标当时国际旗舰的公开宣示。
910B(2023) :并非单一型号,而是按 Cube/Vector 核数与频率切分的 SKU 家族——910B1 为 25 Cube/50 Vector(FP16 约 414 TFLOPS)、910B2 为 24/48(约 376 TFLOPS)、910B3/B4 为 20/40(约 320 TFLOPS),均配 64 GB HBM2e、带宽约 1.2–1.6 TB/s。上述算力为按核数与频率推算的社区口径,华为未逐 SKU 公布官方峰值;最接近官方的系统级口径是 Atlas 800T A2 训练服务器:8×910B、聚合 512 GB HBM、FP16 3.0 PFLOPS / INT8 6.0 POPS、整机最大功耗 10.4 kW [28]。
910C(2025-Q1) :当前量产主力,双 die 合封 (两颗 910B 级计算 die 封装在一起,无中心 I/O die)。2025 年全联接大会官方路线图口径:FP16 800 TFLOPS、HBM 128 GB / 3.2 TB/s、互联带宽 784 GB/s ,支持 FP32/HF32/FP16/BF16/INT8 [1][2]。本报告交叉验证:384×800 TFLOPS≈307 PFLOPS,与 SemiAnalysis 对 CloudMatrix 384"约 300 PFLOPS 稠密 BF16"的测算吻合,可反证 800 TFLOPS 为稠密口径、BF16 与 FP16 同速 [14][15]。
910C 的工程意义大于参数意义:它用两颗成熟制程 die 拼出接近国际旗舰的单卡算力,把"制程落后"转化为"封装与系统"问题;代价是 die 间 SIO 链路(P2P 约 270 GB/s)成为新的带宽瓶颈,也解释了为何 910C 之后华为把互联带宽(784 GB/s→2 TB/s)列为 950 代际的第一优先级。
2.6 910D:一个必须澄清的"传闻型号" 截至 2026 年 11 月,华为官方 AI 芯片路线图为 950PR(2026-Q1)→950DT(2026-Q4)→960(2027-Q4)→970(2028-Q4),910D 不在其中,华为从未发布其数据表 。媒体与分析师的传闻规格跨度极大:FP16 从 320 TFLOPS 到 1.0–1.2 PFLOPS,HBM 从 96 GB HBM2e 到 128 GB HBM3,制程从 SMIC N+2 到 5 nm,封装从双 die 到 4-die chiplet,量产时点从 2025 年底送样到 2026 上半年放量 [27]。
本报告判断 :910D 更可能是早期规划代号或市场传闻的混合物,华为实际选择是以 950 系列直接接续 910C 。任何把 910D 当作"已量产型号"用于产能测算或选型的做法都缺乏依据。
2.7 950 代际:低精度、自研 HBM 与"一芯两用" 2025 年 9 月 18 日,华为轮值董事长徐直军在华为全联接大会 2025 上公布昇腾路线图,跳过 920/930/940,直接给出 950、960、970 三个系列四款芯片,节奏为"几乎一年一代、算力翻倍" [1][2]。
昇腾 950 系列共用一个 Ascend 950 Die,通过合封不同自研 HBM 形成两个 SKU:
昇腾 950PR :面向推理 Prefill 阶段与推荐业务,配自研 HiBL 1.0 (低成本 HBM),主打"重算力、轻带宽",128 GB / 1.6 TB/s。2026 年 Q1 上市,首批形态为标卡(Atlas 350)与超节点服务器。昇腾 950DT :面向推理 Decode 与训练,配自研 HiZQ 2.0 ,内存 144 GB、带宽 4 TB/s,互联 2 TB/s。2026 年 Q4 推出,是 Atlas 950 SuperPoD 的主力芯片。
低精度格式全面铺开 :新增 FP8/MXFP8/MXFP4 与华为自研 HiF8 (保持 FP8 效率的同时精度接近 FP16);相比上代 BF16,MXFP4 张量浮点峰值算力提升最高达 4 倍。这直接对应推理侧低精度量化的产业趋势 [2][18]。SIMD/SIMT 双编程模型 :提升向量算力占比,兼顾大块向量与碎片化数据;内存访问粒度 512 B→128 B。互联带宽 2.5 倍 :从 910C 的 784 GB/s 提升至 2 TB/s,这是万卡超节点得以成立的前提。芯片级集成度提升 :950 把通用 CPU(自研 Linx816 核,支持物理双线程)、DVPP 媒体预处理、安全引擎与 72 Lane HiLink SerDes 集成进同一芯片,整芯片对外 IO 峰值 2 TB/s,原生支持 URMA、UB Memory、PCIe 5.0 与 UBoE [20]。 Atlas 350 标卡(2026-03 上市)是观察"芯片规格 → 商品规格"差异的最佳样本 :官方展台口径为 HBM 112 GB(约为 H20 的 1.16 倍)、FP4 算力 1.56 PFLOPS、显存带宽 1.4 TB/s、整卡功耗 600 W(约为 H20 的 1.5 倍),单卡算力约为英伟达 H20 的 2.87 倍,是国内唯一支持 FP4 的推理产品;内存访问粒度 128 B 使小算子访存效率提升 4 倍,多模态生成速度提升约 60% [23][24]。与芯片级 128 GB / 1.6 TB/s 相比,标卡配置有所下调(112 GB / 1.4 TB/s),原因截至检索时未见官方解释——这提示读者:芯片 datasheet 与可采购商品的规格之间存在工程与成本折衷,选型应以整机/标卡规格为准。
2.8 960 与 970:路线图、提前与不确定性 按 2025 年 9 月官方路线图:昇腾 960 于 2027 年 Q4 推出,FP8 2 PFLOPS / FP4 4 PFLOPS,内存 288 GB / 9.6 TB/s,40 个互联端口,支持自研 HiF4 4 bit 格式;昇腾 970 于 2028 年 Q4 推出,FP8 4 PFLOPS / FP4 8 PFLOPS,内存带宽 14.4 TB/s,互联 4 TB/s [1][2]。
2026 年出现了节奏前移的迹象 :2026 年 9 月 17 日华为全联接大会 2026 上,轮值董事长汪涛发布"全球首个采用 NPO 技术的超节点——昇腾 960 超节点",可扩展至 4096 卡、FP8 8 EFLOPS / FP4 16 EFLOPS,2027 年 Q3 正式上市 ,比原规划的超节点节奏提前 [3]。这意味着 960 芯片的量产节点大概率已从 2027-Q4 前移(有媒体报道称提前至 2027-Q1,但该细节未见华为官网确认)。
必须提醒的风险 :960/970 的制程节点、封装方案、量产良率均未公开;2026 年 11 月的时间点上,960 仍是"已发布产品、未上市",其规格能否按期兑现,取决于中芯国际产能、自研 HBM 迭代与光模块供给三条供应链。把 2027–2028 年的路线图当作确定性事实,是本领域最常见的分析错误 [3][33]。
第三章 Atlas 整机、超节点与集群:系统级竞争力
3.1 Atlas 产品矩阵 Atlas 是昇腾的整机与板卡品牌,按"N 系列训练、I 系列推理、V 系列视频解析、SuperPoD 超节点"分线:
产品线 代表型号 核心配置 定位 开发者/模块 Atlas 200I DK A2、Atlas 200I A2 昇腾 310B,8 TOPS INT8,24 W 边缘开发与嵌入集成 [6] 推理卡 Atlas 300I Pro / 300I Duo / 300V Pro 昇腾 310P,140 TOPS INT8/卡 信创推理、视频解析 [5] 训练卡 Atlas 300T A2 昇腾 910B,64 GB HBM2e 训练节点配卡 训练服务器 Atlas 800T A2 8×910B,512 GB HBM,FP16 3.0 PFLOPS,整机 10.4 kW 智算中心主力机型 推理服务器 Atlas 800I A2 8×910B/310P 组合 大模型推理、一体机 边缘小站 Atlas 500 系列 310/310B 级 SoC 低功耗、宽温边缘部署 集群/超节点 Atlas 900 A3 SuperPoD(CloudMatrix 384)、Atlas 950/960 SuperPoD 384/8192/15488 卡 大规模训练与推理
值得强调的是,华为不主推自有品牌整机,而是通过伙伴出货 :昆仑、华鲲振宇、神州鲲泰、长江计算、宝德、软通华方、百信等七家核心伙伴在 2026 年 3 月同步发布了基于 Atlas 350 的整机产品 [24]。这一模式让昇腾的出货量高度依赖伙伴产能与渠道,也使"昇腾营收"难以从公开财报中直接剥离。
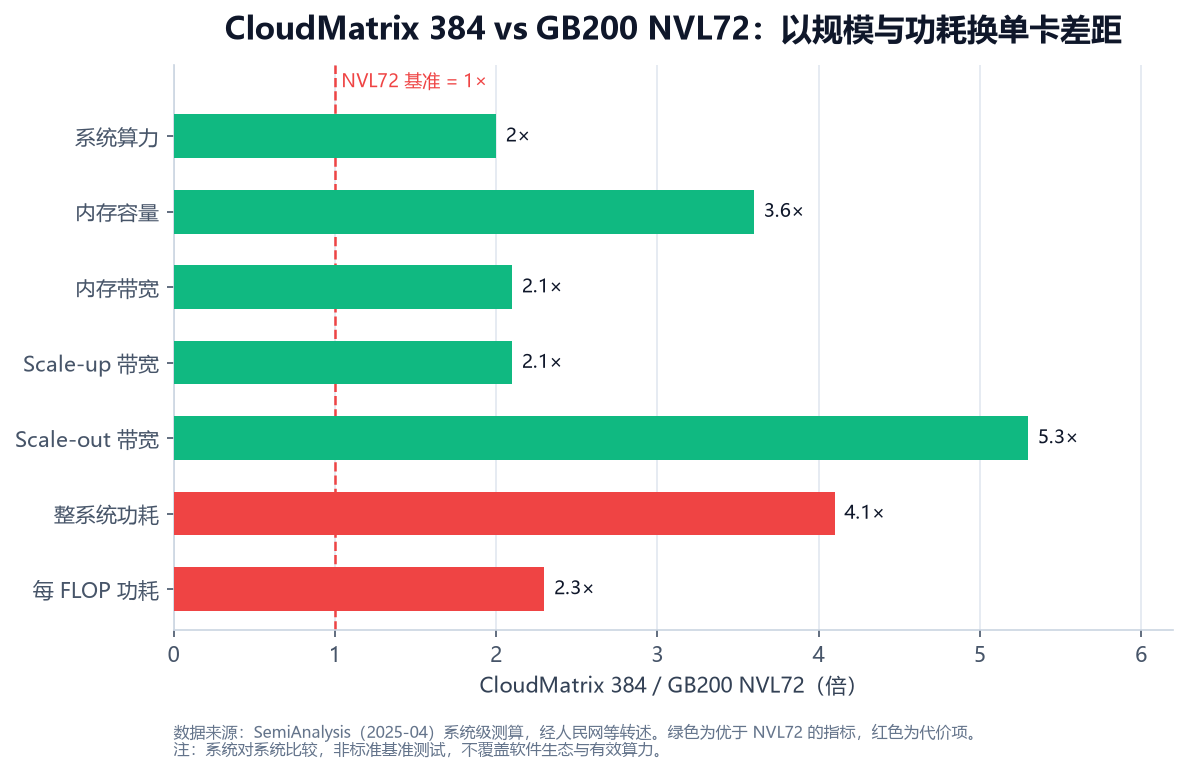
3.2 CloudMatrix 384:昇腾系统级能力的第一次"出圈" CloudMatrix 384(CM384,官方名 Atlas 900 A3 SuperPoD)由 384 颗昇腾 910C 全互联组成,物理上跨 16 个机柜(12 个计算柜 × 32 卡 + 4 个交换柜),采用全光 Scale-up 组网,单系统约 6912 个 400G LPO 光模块 [14]。
第三方评估(SemiAnalysis,2025-04)给出的系统级画像是本报告认为最值得引用的外部结论:
系统级稠密 BF16 算力约 300 PFLOPS ,约为 GB200 NVL72 的两倍;
聚合内存容量为 NVL72 的 3.6 倍 、内存带宽 2.1 倍 、Scale-up 带宽约 2.1 倍 、Scale-out 约 5.3 倍 ;
代价是整系统功耗约为 NVL72 的 4.1 倍 ,每 FLOP 功耗约为对手的 2.3 倍 ;
单颗昇腾芯片性能约为 Blackwell GPU 的 三分之一 ,结论是"华为以规模化系统设计与光互连弥补单芯片差距",并判断其"领先英伟达和 AMD 当前上市产品一代" [14][15]。
对"领先一代"这一定性需要保持清醒 :它是研究机构基于系统对系统(system-to-system)方法与工程拆解的判断,不是标准基准测试,也不覆盖软件生态与有效算力。但它至少证明了一件事:在单卡落后 3 倍的条件下,系统级可以做到 1.5–2 倍反超 ——前提是客户愿意承担 4 倍功耗与更大的机房改造投入。
图 3 CloudMatrix 384 与 GB200 NVL72 系统级对比。图表由点滴安全依据报告引用数据绘制。
部署规模方面,官方口径为:2025 年 3 月开始交付,至 2025 年 9 月累计部署 300+ 套、服务 20+ 客户 ;2026 年 5 月超 500 套、7 月超 750 套;徐直军在 2026 年 10 月称 910C 超节点累计交付"一千多套" [1][21][25][30][33]。
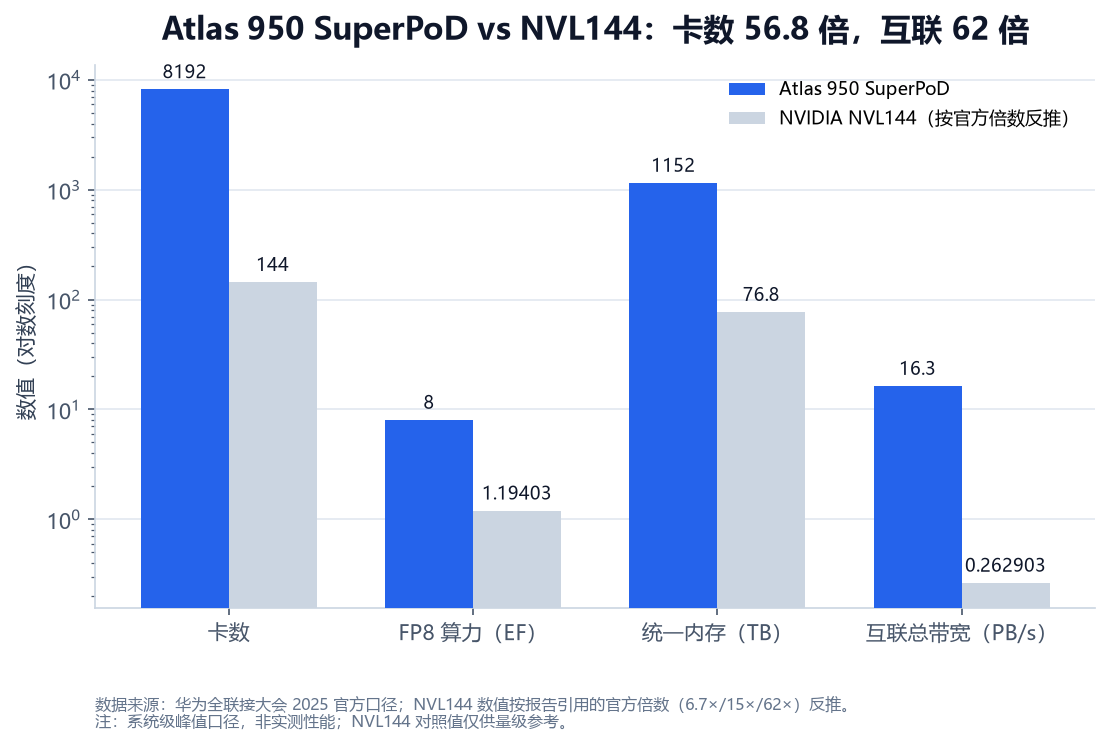
3.3 Atlas 950 / 960:把"卡数竞赛"推到极致 2025 年 9 月发布的 Atlas 950 SuperPoD 是理解昇腾战略的关键产品:
指标 Atlas 950 SuperPoD 对比参照(官方口径) 卡数 8192 张 昇腾 950DT英伟达 NVL144 的 56.8 倍 机柜 128 个计算柜 + 32 个互联柜 = 160 柜,约 1000 ㎡ — 算力 FP8 8 EFLOPS ;FP4 16 EFLOPS NVL144 的 6.7 倍 内存 1152 TB 统一内存NVL144 的 15 倍 互联 16.3 PB/s 总带宽,全光互联NVL144 的 62 倍 性能 训练 4.91M TPS(较 384 超节点 +17 倍);推理 19.6M TPS(+26.5 倍) — 上市 2026 年 Q4 —
数据来源:华为全联接大会 2025 官方口径 [1][2],MWC 2026 海外首展进一步确认 [22]。
图 4 Atlas 950 SuperPoD 与 NVL144 规模对比。图表由点滴安全依据报告引用数据绘制。
本报告做了一次口径自洽性校验 :8192 × 1 PFLOPS(FP8) = 8.19 EFLOPS ≈ 官宣 8E;8192 × 2 PFLOPS(MXFP4) = 16.4E ≈ 官宣 16E;8192 × 144 GB = 1152 TB 与官宣完全吻合;16.3 PB/s ÷ 8192 ≈ 2 TB/s/卡,与单卡 2 TB/s 互联一致。这组校验说明:① 官方系统数字是"单卡峰值 × 卡数"的稠密口径;② Atlas 950 满配采用的是 950DT(144 GB)而非 950PR(128 GB)版本;③ 路线图参数内部自洽,可信度较高。
再往上是集群:Atlas 950 SuperCluster 由 64 个 Atlas 950 超节点互联,52 万余片 950DT,FP8 总算力 524 EFLOPS ;Atlas 960 SuperCluster 规划百万卡级、FP8 2 ZFLOPS / FP4 4 ZFLOPS 。华为同时推荐 UBoE (把 UB 协议承载在以太网上)组网,称其静态时延更低、交换机与光模块更省 [2]。
3.4 2026 年的真实交付:从 8192 卡到 1024 卡 路线图与交付之间存在明显落差,这是 2026 年最值得记录的事实:
950PR :2026 年 Q1 如期发布上市,但徐直军直言"上市量不算大" [25]。Atlas 350 标卡 :2026 年 3 月 20 日中国合作伙伴大会上市,112 GB HBM、FP4 1.56 PFLOPS、1.4 TB/s、600 W,单卡算力约 H20 的 2.87 倍 [23][24]。950 超节点首批为 1024 卡 :2026 年 5 月鲲鹏昇腾开发者大会口径为 16 个计算柜 × 64 卡 = 1024 卡,单柜 FP8 64 PFLOPS / FP4 128 PFLOPS,整机 1 EFLOPS FP8 / 2 EFLOPS FP4;8192 卡属"理论上可达",因"几乎没有客户需要"而暂不首发;950DT 另有 96 GB 内存版本供选配 [21]。WAIC 2026 真机(2026-07) :1024 卡 Atlas 950 SuperPoD 首次公开亮相,256 TB 全局统一内存、端到端 RTT 低至 3 μs、4096 个 800G 光模块、全球首个采用 LPO 的超节点设计,每颗 NPU 对应 2 个 800G 模块(上代为 8 个 400G) [30]。950DT 规模供货 :徐直军在 2026 年 10 月称基于 950DT 的超节点"还在测试中,规模供货应该在今年年底或明年初",并预计"从明年开始,大量模型的训练会构筑在 950DT 超节点上" [25]。2026 年 9 月的新变量 :华为发布"昇腾 960 超节点",4096 卡、FP8 8 EFLOPS / FP4 16 EFLOPS,采用 NPO 光引擎 Hi-ONE(7.2 T/模组),用 5500 个 Hi-ONE 替代原本需要的 48000 颗 800G 光模块,功耗降低超 550 kW,系统可用度 99.8%,2027 年 Q3 上市 [3]。 如何解读"缩配" :一种观点认为是供给约束(HBM、光模块、先进封装)导致无法满配交付;另一种观点认为是需求侧理性——当前国内真正需要 8192 卡单一训练任务的客户极少,1024 卡更贴合实际订单。两种解释并不互斥。对分析者的含义是:不要把"最大规格"当作"当前产能" ,也不要把"1024 卡"当作"技术上限"。
3.5 灵衢(UnifiedBus)、光互联与 Peerium:系统级竞争力的技术底座 (1)灵衢 UB:一套协议打通 Scale-up 与 Scale-out。 英伟达用 NVLink(柜内)+ InfiniBand(柜间)两套协议,跨协议转换至少微秒级;UB 用单一协议"把网络当总线做",数据包从 scale-up 到 scale-out 约 150 ns ,转换开销节省一个数量级;柜间带宽最高 800 GB/s ,跨柜时延 2.1 μs 。芯片侧原生支持 URMA、UB Memory、PCIe 5.0、UBoE,既可跑专用物理层也可承载于以太网。华为于 2025 年 9 月宣布开放灵衢 2.0 技术规范 ,2026 年 5 月与楠菲微电子、牛芯半导体、上海方宜万强、上海合见工软等首批六家生态伙伴签约 [2][25][50]。
(2)光互联:NPO 而非 CPO。 Atlas 950 采用"基本全光"设计,华为发布基于 NPO(近封装光) 的 Hi-ONE 模组,单模组 7.2 T 带宽,光引擎距主芯片仅约 5 cm,仅此段用铜线;模组内置光源(而非外置激光器分光),相比 CPO 方案成本降低近 40%,且光引擎故障不会连带报废 AI 芯片。徐直军明确表示华为"很早就达成共识做 NPO,没做 CPO",并称该方案"未来两到三年内其他厂商很难做出来" [3][25]。
(3)Peerium 计算架构。 2026 年全联接大会提出,核心是嵌套并行(Nested BSP)与平等互联,目标让 25.6 万卡乃至百万卡"逻辑上成为一台计算机";配套发布 L3.5 层 PB 级 KV 缓存方案 OceanStor M900,以及最大 4096 节点、256 TB 统一内存池的鲲鹏超节点 [3][25]。
本报告的判断 :昇腾的系统级路线是"以光换距离、以规模换算力、以内存池换单卡容量"。它在"能不能训出大模型"这个问题上已经给出肯定答案,但在"单位算力成本与能效"上付出了明确代价(CM384 每 FLOP 功耗约为 NVL72 的 2.3 倍)。这条路线能否持续,取决于三个变量:光模块与液冷的成本曲线、国产 HBM 的容量/带宽爬坡速度、以及客户是否愿意为"自主可控"支付能效溢价。
第四章 软件栈与生态:CANN、MindSpore 与开源运动
4.1 CANN 八年演进:从"使能平台"到"异构计算架构"再到"可裁剪组件集" CANN(Compute Architecture for Neural Networks)是昇腾的异构计算架构,向上对接框架、向下管理芯片。其版本演进可分为四个阶段:
版本 时间 关键能力 阶段特征 1.0 2018-09 作为"昇腾 AI 使能平台"诞生 配套 310/910 首发 3.0 2020-08 定型为"面向 AI 场景的异构计算架构",明确中间层定位 架构定型 5.0 2021-12 任务自动流水、软硬协同;官方称典型推理性能 +30%~140%、集群训练性能翻番 第一次架构级重构 6.0 2022-11 开发体系 2.0、原生 C/C++ 算子开发;官方称 1400+ 算子、迁移成功率 80%+ 算子与迁移能力补齐 7.0 2023 下半年 大模型专项:自动并行切分、KV Cache 分布式存储、FlashAttention 融合算子、Auto Batching 转向大模型 8.0 2024-09 200+ 基础算子、80+ 融合算子、NB2.0/NHR 集合通信算法、LLMDataDist、TorchAir 图模式 大模型原生 8.1/8.2/8.3 2025 年内 RC 迭代,vLLM-Ascend 要求 ≥8.2.RC1 快速迭代 8.5.0-beta.1 2025-12-30 子包独立升级与配套矩阵成型 分层解耦 9.0.0 2026 上半年 支持 Ascend 950PR/Atlas 350、apt/pip 安装、HCCL 批量通信合并、FP8/MXFP8/MXFP4 新硬件适配 9.1.0 2026 年中 支持 Ascend 950DT、SMLA/mHC 算子、Python 3.14、openEuler 24.03 LTS SP4 生态扩围 9.2.x 2026-10 前 支撑 vLLM-Ascend v0.30.0 正式发布 与上游对齐
数据来源:昇腾社区 CANN 版本文章与版本说明 [7][8][13][65],vLLM-Ascend 发布说明 [11]。
9.x 最重要的变化是"分层解耦"落到软件包粒度 :一个 Toolkit 组合包含 22 个子包,ops 与 Toolkit 可独立升级、跨三个大版本互配。这解决了 8.x 时代"Toolkit/ops/驱动版本必须严格对齐"的痛点,但也带来新的版本矩阵复杂度——社区反馈的典型故障是 torch / torch-npu / CANN 三者未按映射表对齐时的"符号找不到、初始化失败" [7][8]。
4.2 软件栈分层与组件 层次 组件 职责 状态 应用与工具 MindStudio、MindX、ModelArts IDE/调优可视化、行业使能套件、云上平台 部分开源/云服务 框架适配 TorchNPU (含 OpPlugin、TorchAir)、MindSpore 、TensorFlow 适配框架到 NPU 的桥接 TorchNPU 开源(BSD-3) 加速库 ATB(ascend-transformer-boost)、SiP、ops-collections Transformer/信号/领域加速 已开源 算子库 ops-nn、ops-math、ops-cv、ops-transformer、opbase 内置与融合算子 已开源(CANN 许可证 2.0) 通信库 HCCL 、HCOMM、HIXL(单边)、SHMEM集合/单边/共享内存通信 已开源 图引擎 GE(ge-compiler/ge-executor)、metadef、graph-autofusion 图编译、融合、下沉执行 2025-12 上仓 编程与编译 Ascend C (asc-devkit)、PyPTO/PyASC、PTO-ISA、毕昇编译器算子编程、Tile 级 ISA、编译器 已开源;950 起支持 SIMD+SIMT 运行时与驱动 runtime、driver 设备/内存/流管理(aclrt) 已开源 模型转换与调优 ATC、AOE、AMCT、msprof、msprobe 离线编译、自动调优、量化、性能/精度分析 工具多闭源、接口开放
三处关系需要点明:其一,ATC 仍是离线部署主入口 (pb/onnx → om),7.0 起支持 --distributed_cluster_build 在编译期切分并插入通信算子;其二,HCCL 是性能与稳定的关键路径 ,8.0 的 NB2.0 把带宽利用率从不足 40% 提到 60%+(官方口径),9.0 又补了批量通信合并接口;其三,Ascend C 已从"TBE/TIK 的替代"演化为唯一推荐的算子开发语言 ,950 代际新增约 700 个 SIMT API 与 90+ Reg 编程接口 [8][13]。
4.3 2025–2026 开源开放:进度、规模与"开源成色" 时间线可交叉验证为四步:2025 年 8 月徐直军宣布 CANN 全面开源开放;9 月 20 日 HC2025 宣布成立 CANN 技术指导委员会,给出"9 月底全量算子开源到 GitCode、12 月领域加速库/图计算/Ascend C/MindIE 陆续上仓"的时间表,并承诺每年投入 1500P 算力与 3 万块开发板;2025-12-31 宣布完成开源开放;2026 年 9 月表述升级为"已进入常态化开源社区运作" [3][4][28]。
规模数据需区分口径:官方 2026-01 口径为"30+ 项目、1500+ 开发者、代码合入 26 万行";2026 年 11 月社区页面静态指标为 92 个仓库、57.56K Star、29.1K Fork、122.75K PR、83.4M 下载 [28][29]。十个月增长显著,但 Issue/PR 中含大量机器人与内部流水线提交,不宜直接等同于外部贡献者活跃度。
必须记录的"非技术变量"是许可证。 CANN 开源仓统一采用《CANN Open Software License Agreement Version 2.0》,授权仅限"为在华为 AI 处理器和/或本软件的系统上开发软件"之目的,明确禁止用于非华为处理器系统,且可撤销、不可转让、不可再授权。这意味着它不满足 OSI 开源定义中"不得限制使用领域"的要求——"开源"在此处是产业语境的"源码开放",与 FSF/OSI 语境存在实质差别,也是海外开发者最主要的质疑点 [9]。
4.4 训练框架:MindSpore 2.x 与套件族 MindSpore 于 2020-03-28 开源,当前可核实的最新稳定线为 2.8(2026-01-29) ;2.7(2025-07-27)聚焦超大规模集群,MoE 训练性能提升 70%、推理吞吐提升 15%,支持 Capacity/Dropless 双模式负载均衡,并首次在单台 Atlas 800I A2(64 GB)上部署 DeepSeek 671B;2.8 与超节点协同设计,提出 HyperParallel 架构(HyperShard 声明式并行、HyperOffload 多级卸载、HyperMPMD 非规则异构并行),vLLM 适配升至 v0.11.0、接入 ACLGraph 图下沉,并与 SGLang 社区合作适配 Radix Cache [12][67]。
需要纠正一个流传较广的说法:截至检索时,MindSpore 并不存在已发布的 3.x 版本 ,最新稳定线为 2.8。配套套件包括 MindFormers(大模型全流程开发套件)、MindSpeed(对接 Megatron 的训练加速库,文档线已至 26.x)、MindPet(轻量微调)。
4.5 推理生态:MindIE、vLLM-Ascend、SGLang
MindIE :昇腾自研推理引擎与服务化套件(MindIE-LLM/MindIE-SD/MindIE-Torch),文档线为 2.0.RC2,已纳入 2025 年底开源范围。vLLM-Ascend :社区最活跃的对接点,与上游 vLLM 严格 main2main 对齐。v0.23.0 于 2026-08-16、v0.30.0 于 2026-10-29 发布,依赖栈为 upstream vLLM v0.30.0 + CANN 9.2.1 + torch_npu 2.10.0 + Triton-Ascend 3.6.0。其发布说明中官方自列的已知问题(Kimi K3 长输入草稿接受率偏低、DeepSeek-V4-Flash 128K/1K 场景开启池化后性能回退、Qwen3-235B 在 A3 PD 混合下低于基线等)是观察"宣称 vs 实测"落差的最好材料——由官方自己披露,属于可采信的证据 [11][66]。SGLang-Ascend :MindSpore 2.8 已与 SGLang 社区合作完成 Radix Cache 等核心特性适配,但具体发版号未取得一手 release note。
4.6 PyTorch 适配与迁移成本:为什么"改一行代码"是误解 TorchNPU(原 torch_npu,现统一更名为 Ascend Extension for PyTorch)是昇腾接住 PyTorch 生态的唯一主通道。26.1.0(2026 年 7 月)采用"PyTorch 版本–TorchNPU 版本"双轨分支,单树支持 PyTorch 2.7.1 / 2.9.0 / 2.10.0 / 2.11.0 / 2.12.0 ,兼容 CANN 8.5.X / 9.0.X / 9.1.X [10]。
关于"算子覆盖率 90%+"这类说法,本次检索未能在官方文档或 TorchNPU 仓库找到可引用的原始出处与统计口径;可核实的替代指标是官方按 PyTorch 版本逐版发布的《原生 API 支持清单》。因此本报告不采信任何未标注口径的覆盖率百分比。
框架级自动迁移 :官方提供"最简单的自动迁移"样例,多数模型可跑通,但"能跑"与"跑得好"之间隔着图模式适配。CUDA Runtime 兼容层 :社区项目用 typedef aclrtStream cudaStream_t 之类的零开销映射,把 cudaMalloc/Memcpy/Stream/Event 映射到 aclrt,但承认三类硬边界——不支持 Unified Memory、不支持 CUDA Graph 捕获、不支持 Texture/Surface,且 warp 宽度由 32 变 1 。这从反面说明 CUDA 的编程假设在昇腾上并不成立 [31]。算子级重写 :Ascend C 是独立语言与独立架构,人力成本应按"新语言 + 新架构"计。社区迁移指南把流程拆成环境准备、组件联调、精度对齐、性能优化、评测验证五段,并给出真实案例:推理侧 LayerNorm 有升 FP32 操作而训练侧没有、k_norm 的 eps 推理侧硬编码 1e-6 而训练侧为 1e-5、推理侧缺少 weights 缩放、训练侧多出仅用于量化的 rotate_activation;此外 A2/A3 暂不支持 FP8 训练(仅 BF16),MoE 大模型需引入 Routing Replay 才能保证训推一致 [31]。 一个被低估的事实 :昇腾把更多责任压给编译器,图模式才是主场,eager 模式是为兼容 PyTorch 生态补的路径。这意味着"按 CUDA 经验估迁移工时"的项目普遍超期 [31]。
4.7 Hugging Face、上游社区与模型厂商:生态的"软接口" Hugging Face 本身不发布昇腾性能基准,其价值在于权重分发与上游适配的汇聚点 。2026 年可以观察到的生态接口有四类:
上游框架侧的 NPU 后端 :vLLM-Ascend 维护官方"支持模型矩阵",按模型逐项标注支持状态与限制 [66];社区项目(如 SLAI-AscendBridge)专门做"基于 Hugging Face Transformers 的昇腾 NPU 适配验证",把 HF 模型在前端 API 不变的前提下迁到 NPU [32]。模型厂商的 Day-0/Day-N 适配 :智谱 GLM-5.2 开源当日昇腾 0 Day 支持,围绕 MoE 大融合算子、通信计算融合、PD 分离与 Prefix Cache 优化 [47];阶跃星辰开源 Step 5 Preview 权重时,华为昇腾、沐曦、壁仞首发支持 [48];MiniMax M2.5 发布后昇腾"数小时完成适配"并在多个现网局点试用。国产大模型的全栈适配 :2026 年 5 月 DeepSeek V4 发布并开源,同时宣布全面适配昇腾,被称为"国产大模型首次在国产芯片上完成从训练到推理的全栈部署";寒武纪、摩尔线程、海光等也宣布 Day-0 适配,标志"模型发布即适配"成为行业惯例 [46]。量化与推理优化社区 :ModelArts、魔搭(Modelers)等平台的模型页普遍提供昇腾推理配置与量化版本,形成"权重在 HF/魔搭、推理在 vLLM-Ascend/MindIE"的分工。 但要警惕"适配 ≠ 采购" :Day-0 适配是兼容性承诺,不等于云厂商或模型公司会大规模采购昇腾。截至检索时,阿里、字节、腾讯均未发布大规模采购昇腾的一手公告,相关采购量只有咨询机构的预测值。
4.8 生态规模与短板 规模数据(按年份区分口径) :截至 2024 年底,鲲鹏+昇腾开发者超 665 万、合作伙伴超 8500 家;其中昇腾开发者 330 万+、硬件伙伴 60+、行业伙伴 2500+;MindSpore 下载 1100 万+、服务企业 5500+。截至 2025 年底,昇腾开发者 400 万+ 、合作伙伴 3000+ 、孵化行业解决方案 6700+、80+ 硬件伙伴发布 200+ 产品;MindSpore 全球下载超 1300 万次、覆盖 130 多个国家和地区;CANN 侧 ISV 超 3000 家,60 多家客户与伙伴自研 420 多个高性能算子 [28][29]。
许可证与"开源"叙事不一致 (见 4.3);自定义算子与调试工具薄弱 :9.1.0 才把"NPU Check、SIMD VF 内 printf/reg dump、L1 Tensor DumpTensor"列为新增维测能力,反向说明此前体验不足;通信库可靠性细节 :CANN 9.0.0 版本说明自列两条已知问题——int64 集合通信算子不支持重执行流程,断链时快恢从分钟级拉长到十几分钟;跨超场景 sendrecv 偶现卡死导致进程级恢复失败且"物理跨超暂无规避方案"。这是官方文档级别的自认短板,比任何第三方评测更有说服力 [8];框架版本滞后与代际断点 :TorchNPU 26.1.0 才补齐 PyTorch 2.11/2.12;Ascend 950DT 明确"仅支持 Inductor 后端中的 Triton 与 DVM 模式,暂不支持 MLIR 模式",且因架构变更部分算子与通信接口存在非兼容调整 [10];版本碎片化 :8.x 时代 RC 密集迭代 + 子包独立升级,形成"Toolkit/ops/子包/CANN 大版本/驱动 HDK"多维配套矩阵。 结论 :CANN 的"可用性"在 2026 年已跨过拐点(主流模型 Day-0、400 万开发者、PyTorch/vLLM 上游对接),但"好用性"仍与 CUDA 有代差,差距集中在图模式调优、算子级性能、调试工具链与通信稳定性四处。对企业的现实含义是:迁移预算应按"重写 20%–40% 的算子与工程适配"估,而不是按"改几行 import"估 。
第五章 与主流 AI 芯片的对比分析
5.1 单卡对比:差距 1–3 倍,且短期内不会消失 下表统一采用单卡、稠密 口径;"—"表示官方未公开,不做事后估算。
芯片 制程 BF16/FP16 FP8 FP4 HBM 类型/容量/带宽 TDP FP8 能效(TF/W) H100 SXM 台积电 4N 0.99 PF 1.98 PF — HBM3 80 GB / 3.35 TB/s 700 W 2.8 H200 4N 0.99 PF 1.98 PF — HBM3e 141 GB / 4.8 TB/s 700 W 2.8 B200 4NP 双 die 2.25 PF 4.5 PF 9 PF HBM3e 192 GB / 8 TB/s 1000 W 4.5 B300 4NP ≈4.5 PF* ≈7.5 PF* 15 PF HBM3e 288 GB / 8 TB/s 1400 W 5.4 MI300X 5/6 nm 1.3 PF 2.6 PF — HBM3 192 GB / 5.3 TB/s 750 W 3.5 MI355X 3 nm 2.5 PF 5.0 PF 10 PF HBM3e 288 GB / 8 TB/s 1400 W 3.6 MI400(2026) 3 nm ≈5 PF* 10 PF 20 PF HBM4 432 GB / 19.6 TB/s 未公开 — Ironwood(v7) — — 4.614 PF — HBM3e 192 GB / 7.2 TB/s 未公开 — 昇腾 910B 中芯 7 nm 级 0.32–0.414 PF — — HBM2e 64 GB / 约 1.2–1.6 TB/s 300–400 W — 昇腾 910C 双 die 7 nm 级 0.80 PF — — 约 128 GB / 3.2 TB/s 约 600 W(板卡) — 昇腾 950PR 国产工艺 — 1.0 PF 2.0 PF(MXFP4) 自研 HiBL 1.0,128 GB / 1.6 TB/s 未公开 — 昇腾 950DT 国产工艺 — 1.0 PF 2.0 PF(MXFP4) 自研 HiZQ 2.0,144 GB / 4 TB/s 未公开 — 昇腾 960(规划) 未公开 — 2.0 PF 4.0 PF 288 GB / 9.6 TB/s 未公开 —
注:B300 的 FP16/FP8 为按 FP4 折半推算,MI400 同理由 FP8 折算。数据来源:NVIDIA/AMD/Google 官方规格与发布会 [57][58][59][60],昇腾为官方路线图与系统值反推 [1][2][27]。
(1)制程代差是硬约束。 英伟达 4NP、AMD 3nm、Google/AWS 已进入 3nm 及以下规划,华为被限制在中芯 7nm 级,只能靠双 die 封装与超节点补偿。以 BF16 稠密算力计:910C 约为 H100 的 0.8 倍、B200 的 1/3、B300 的约 1/6;950 系列虽然把 FP8 做到 1 PFLOPS,但仍低于 B200 的 4.5 PF。
(2)内存是第二道坎。 B300/MI355X 的 288 GB HBM3e、8 TB/s 已是单卡上限,MI400 更把 HBM4 推到 432 GB / 19.6 TB/s;昇腾 950DT 用自研 HBM 做到 144 GB / 4 TB/s,容量与带宽均约为对手一半。自研 HBM 的真正价值不在参数,而在"不被卡脖子"——这是 2024 年 12 月美国对华先进 HBM 管制后昇腾最重要的供应链决策 [49]。
(3)能效差距在收敛,但昇腾缺数据。 从 H100 的 2.8 TF/W 到 B300 的 5.4 TF/W,两代翻倍;AMD 维持在 3.5 上下。昇腾未公开单卡 TDP(Atlas 350 的 600 W 是整卡含 HBM 的功耗),无法计算单卡能效,只能用系统级数据替代——这本身说明"能效"仍是昇腾叙事中的弱点。
5.2 系统级对比:Scale-up 域的规模竞赛 系统 厂商 Scale-up 规模 域内互联 系统算力(稠密) 状态 GB200 NVL72 NVIDIA 72 GPU NVLink5 1.8 TB/s/卡,域内约 130 TB/s 324 PF FP8 / 约 180 PF BF16 规模出货 GB300 NVL72 NVIDIA 72 GPU 同上 1.1 EF FP4 2025H2 起出货 CloudMatrix 384 华为 384×910C 全光互连,6912×400G LPO 约 300 PF BF16 已部署 1000+ 套 Atlas 950 SuperPoD 华为 8192×950DT 灵衢 UB 2.0 全光,16.3 PB/s 8 EF FP8 / 16 EF FP4 2026Q4 上市;首批 1024 卡 Atlas 960 SuperPoD 华为 15488 卡 灵衢 30 EF FP8 / 60 EF FP4(规划) 2027Q4 规划 昇腾 960 超节点 华为 4096×960 灵衢 + NPO Hi-ONE 8 EF FP8 / 16 EF FP4 2027Q3 上市 Ironwood Pod Google 9216 TPU ICI + OCS 光交换 未公开系统值 2025 起 TPU 8t Pod Google 9600 芯片 — 121 EF FP4(目标) 2027 量产目标 Trn3 UltraServer AWS 144 芯片 NeuronLink 未公开 2025-12 发布 Helios AMD 72 MI400 UALink 260 TB/s 约 1.44 EF FP4(推算) 2026
数据来源:NVIDIA/AMD/Google/AWS 官方与发布会 [57][58][59][60][61][62],华为官方 [1][2][3],系统级第三方测算 [14][15]。
英伟达路线 :"把 72 卡做成一颗大 GPU"。NVLink5 单卡 1.8 TB/s,铜缆域内聚合约 130 TB/s,靠 CUDA 让软件吃满带宽,再由 InfiniBand 做 Scale-out。优势是域内时延极低、软件成熟;劣势是域规模受铜缆物理限制(NVL72/NVL144)。华为路线 :"把 8192 卡做成一台计算机"。单卡互联弱于 NVLink,就把域扩到 384、4096、8192、15488 卡,用灵衢 UB 2.0 与全光互联换取规模,用统一内存编址换取内存池。优势是规模与内存容量;劣势是时延(跨柜 2.1 μs)、功耗与工程复杂度。 系统级谁更强?取决于问什么问题。 若问"单集群能否承载 10 万亿参数模型的训练",华为的 8192 卡、1152 TB 内存池在纸面上强于 NVL144;若问"单位算力成本与能效",英伟达仍显著领先(CM384 每 FLOP 功耗约为 NVL72 的 2.3 倍);若问"软件与生态成熟度",CUDA 仍是事实标准。"昇腾已超过英伟达"的说法只在"中国市场可获得的算力供给"这一特定语境下成立 (徐直军 2026 年 10 月称按华为可统计口径昇腾份额已超英伟达)[25][26]。
5.3 差距究竟在哪里:四个层次
制程与能效 (硬差距,短期无解):7nm 级 vs 3/4nm,直接决定单卡算力上限与每瓦性能。HBM (半硬差距,正在改善):自研 HiBL/HiZQ 已上机,但容量与带宽仍约为国际旗舰一半,且产能爬坡需要时间。互联 (已部分反超):UB 2.0 的柜间 800 GB/s、2.1 μs 时延、全光组网,在"大规模"维度上优于 NVLink+IB 的两级架构;但单卡互联带宽(2 TB/s)仍低于 NVLink5(1.8 TB/s 为单向,双向更高)。软件生态 (软差距,最难补):CUDA 有 20 年积累、数百万开发者、成熟算子库与调试工具;CANN 只有 8 年、400 万开发者、算子覆盖与工具链仍逊。迁移成本是客户最真实的门槛。
5.4 国产 AI 芯片横向对比:昇腾的"一超多强"格局 厂商/型号 制程 BF16/FP16 FP8/INT8 HBM 互联/集群 状态 昇腾 910C 7nm 级双 die 0.80 PF — 约 128 GB / 3.2 TB/s CloudMatrix 384 主力在售 昇腾 950PR/950DT 国产 — 1 PF FP8 / 2 PF MXFP4 128/144 GB 灵衢 2.0 2026 分批上市 寒武纪 590 未公开 0.345 PF — 96 GB HBM2e — 量产 寒武纪 690 双 die >0.7 PF — 196 GB HBM3 实测互连 >890 Gbps 2026 初量产 海光 深算三号 未公开 未公开 未公开 未公开 — 第二梯队 壁仞 BR100 7nm / 770 亿管 厂商称 1024 TFLOPS† — 64 GB HBM2e — 小批量 沐曦 C600 全国产 7nm — FP8 ≈1000 TFLOPS / INT8 2000 TOPS 144 GB HBM3e / 3.35 TB/s — 2026-05 量产 摩尔线程 未公开 未公开 未公开 未公开 KUAE 集群 2025-12 上市 天数智芯 未公开 未公开 未公开 未公开 — 第三梯队 燧原 S60/L600 S60 为 N6 S60 单核 80 TFLOPS S60 单核 80 TOPS HBM2 512 GB/s GCU-LARE 200 GB/s、64 卡/柜 L600 2025 发布
† 壁仞 BR100 的 1024 TFLOPS 为 2022 年厂商宣传值,第三方资料给出 256 TFLOPS(疑为 FP32 口径)、64 GB HBM2e、550 W,两种口径差异极大,引用需谨慎。海光、天数、摩尔线程的 FP8 与 HBM 完整规格官方未披露,表格留白而非估算 [63][64]。
昇腾的护城河是"全栈 + 自研 HBM + 超节点" :国内唯一同时具备芯片、互联协议、光引擎、编译器和框架的厂商;950 系列用自研 HBM 绕开韩系供应限制。寒武纪是第二极 :690 双 die、FP16 超 700 TFLOPS、196 GB HBM3,2026 年初量产,字节累计部署超 10 万张 590/690;2026 前三季营收 95.26 亿元、净利 37.15 亿元,同比增长 106.76%/131.49% [63]。第三梯队靠资本市场与细分场景续命 :沐曦 2026 年 5 月量产 C600 并首次盈利;摩尔线程、壁仞、燧原相继上市。规格不透明本身也是信息——海光、天数、摩尔线程至今未公开 FP8 与 HBM 完整口径,说明其产品仍以特定客户定制为主。
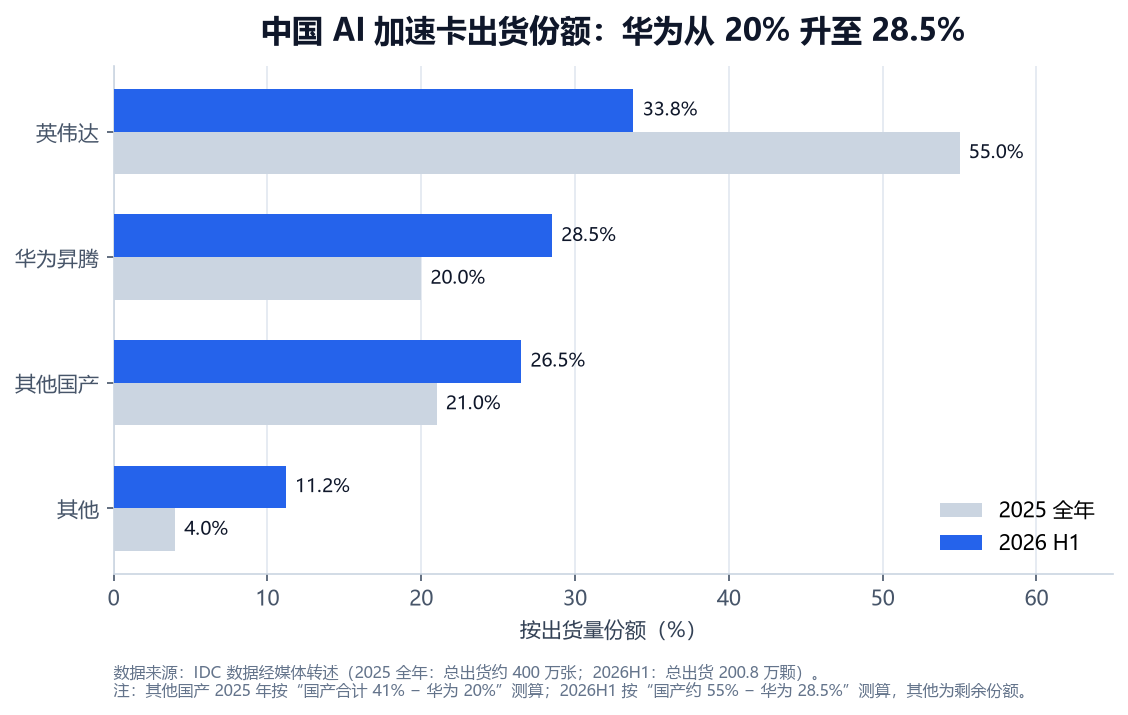
5.5 出口管制下的中国市场:份额拐点已过 口径 时间 英伟达 华为 其他 出货量(IDC) 2025 全年 约 55%(220 万颗) 约 20%(81.2 万颗) 国产合计 41% 出货量(IDC) 2026H1 33.8%(67.8 万颗,-44%) 28.5%(57.2 万颗) 国产合计约 55% 收入/价值(Bernstein 预测) 2026E 约 8% >50% 其他国产瓜分 高端市场(TrendForce 预测) 2026E 约 10% 领先 国产合计约 90%
数据来源:IDC 经媒体转述 [34][35][36],Bernstein/TrendForce 预测 [37]。
图 2 中国 AI 加速卡出货份额:华为从 20% 升至 28.5%。图表由点滴安全依据报告引用数据绘制。
2026 年上半年,中国 AI 加速器总出货约 200.8 万颗,其中 GPU 出货 99.1 万颗(-26%)、非 GPU 加速器 101.6 万颗(+80%)——非 GPU 首次超过 GPU,昇腾正是这一结构性变化的最大受益者 ;IDC 预计 2026 全年 GPU 出货同比 -9%、AI 加速器整体 +19% [35]。
出口管制的时间线值得完整记录 :2025 年 4 月美国要求 H20 对华出口须获许可,英伟达计提约 55 亿美元库存损失;2025 年 8 月许可证恢复发放,但须上缴对华销售收入 15%;由于中国客户担心"算力栈被卡",H20 复售需求远低于预期;2026 年初英伟达停产 H20,转向 B30/B30A 与 RTX Pro 系列降规特供,H20 的算力据不同估算仅为 H100 的 15%–33% [37]。2026 年 10 月,美国 FCC 首次依据"含逻辑处理能力的硬件组件"新规拦截含海思芯片的设备,标志管制节点从整机下沉到零部件;同期约 60 万块 H200 滞留香港等待进口批准 [54][55]。
管制的净效果是加速替代而非遏制。 但必须注意:按出货量计算的份额(华为 28.5%)与按收入计算的份额(Bernstein 预测华为 >50%)差异巨大,前者说明"颗数领先",后者说明"金额领先",两者不能混用。"国产过半"在 2026 年仍是预测,不是已被年度数据证实的事实。
5.6 纸面算力不等于实测性能 MLPerf Training 6.0(2026 年 6 月)给出了当前最硬的第三方数据:GB300 NVL72 在同规模下比 GB200 NVL72 训练快最多 1.6 倍;DeepSeek-V3 671B 跑到 8192 卡,CoreWeave 用 GB300 NVL72 把 DeepSeek-V3 做到 2.02 分钟;NVIDIA 还用 NVFP4 预训练了 5500 亿参数的 Nemotron 3 Ultra,说明低精度训练已可用于前沿规模 [57]。
但同一张榜单看不到华为、寒武纪。 国产厂商基本不参与 MLPerf,跨体系实测数据因此缺失。可用的只有厂商口径与第三方估算:CloudMatrix 384 的每 FLOP 功耗是 GB200 NVL72 的 2.3 倍;科大讯飞称星火在昇腾上训练推理性能达业界 90% 以上(企业自述);清华计图团队在昇腾上把 DeepSeek V2 推理较 vLLM(Ascend 版)提升 44.0%–90.3%(第三方学术,衡量的是框架优化增益而非跨体系对比)[44][45]。
本报告判断 :纸面算力大概只能解释 30%–50% 的实际性能差异,剩余部分由互联效率、编译器成熟度、算子覆盖与集群稳定性决定。这也是为什么"昇腾单卡只有 H100 的 0.8 倍,但 CM384 系统级能到 NVL72 的 1.6 倍"并不矛盾——系统设计与工程优化可以放大或缩小纸面差距。
第六章 典型应用案例与产业落地
6.1 三大运营商:昇腾的"压舱石" 客户 项目 规模/指标 来源 中国移动 哈尔滨智算中心 1.8 万张 AI 加速卡、6.9 EFLOPS(半精度)、2304 台服务器、150 PB 存储、46 kW 风冷 [39] 中国移动 呼和浩特智算中心 约 2 万张加速卡、AI 芯片国产化率超 85% 、6.7 EFLOPS,全球运营商最大单体智算中心 [38] 中国移动 贵阳等节点 与哈尔滨、呼和浩特合计近 6 万张 AI 加速卡 [70] 中国电信 天翼云上海临港 国内首个国产单池万卡液冷 集群,园区规划 15000 卡,首批 8 家伙伴入驻 [40] 中国联通 京北推理智算中心 门头沟、海淀温泉千卡级资源池,"一训一推"布局,训推共池动态调度 [33]
集采可交叉验证:中国电信 AI 服务器集采 4175 台训练型服务器、约 84 亿元;中国联通首次总部集采 2503 台 AI 服务器 + 688 台 ROCE 交换机、约 40 亿元;中国移动 2024–2025 年新型智算中心集采 8054 台硬件(含 7994 台 AI 服务器),加 2023–2024 年试验网 12 标包 2454 台,两轮合计超万台 [38]。
哈尔滨数据是本报告认为最可信的一组 :它同时披露卡数、算力、服务器台数与制冷方案,可反推单卡有效算力与机柜功率密度(6.9 EFLOPS ÷ 1.8 万卡 ≈ 0.38 PF/卡,接近 910B 的标称值),可信度高于纯宣传通稿。呼和浩特"国产化率超 85%"则说明:运营商集采的国产化率不是市场自然选择的结果,而是行政要求与供应链安全共同推高的 。
6.2 "东数西算"枢纽:从机房到"词元工厂"
芜湖 :2025 年 4 月华为云生态大会宣布 CloudMatrix 384 超节点集群在芜湖数据中心规模上线,称其为"国内唯一正式商用的大规模超节点集群";同场披露昇腾 AI 云服务已适配含 DeepSeek 在内的 160 多个第三方大模型 [41]。贵安 :公开披露多为"华为云贵安数据中心""最大规模 AI 算力集群"等定性表述,缺与卡数对应的官方一手数字。庆阳 :2026 年 10 月科技日报报道其算力规模达 30.6 万 P、较 2025 年底增长 168%、机房日均 Token 调用量 12 万亿次(约占全国 10%)。但 30.6 万 P 是多厂商集群总算力,不能等同于昇腾算力 ,这是引用地方数据最常见的误读 [68]。
6.3 大模型与互联网:从"能跑"到"原生开发"
科大讯飞 :2023 年 10 月推出国内首个万卡规模大模型算力平台"飞星一号";2024 年披露星火在昇腾上训练推理性能"普遍达业界 90% 以上",完全基于昇腾原生开发训练的星火 V4.0 在 12 项中英文测试中 8 项超 GPT-4 Turbo [44]。DeepSeek :2026 年 5 月 DeepSeek V4 发布并开源,同时宣布全面适配昇腾,被称为"国产大模型首次在国产芯片上完成从训练到推理的全栈部署";寒武纪、摩尔线程、海光等也宣布 Day-0 适配 [46]。更早的第三方成果是清华计图团队 2025 年 4 月在昇腾 910 系列上实现单台 8 卡服务器运行 DeepSeek-R1 推理,并把 DeepSeek V2 推理性能较 vLLM(Ascend 版)平均提升 53% 以上 [45]。智谱 / 阶跃 / MiniMax :GLM-5.2 开源当日昇腾 0 Day 支持 [47];Step 5 Preview 开源时昇腾、沐曦、壁仞首发支持 [48];MiniMax M2.5 发布后昇腾"数小时完成适配"并在多个现网局点试用。互联网大厂 :阿里、字节、腾讯均未发布大规模采购昇腾的一手公告,相关采购量只有咨询机构预测(2026 年约 65 万片),属预测值而非事实。 "Day-0 适配"的正确解读 :它证明国产芯片的适配周期已从"数月"压缩到"数日",是生态成熟的标志;但它不等于采购承诺,也不等于性能达标——适配只保证"能跑",是否"跑得好"要看各家 vLLM-Ascend 发布说明里那些官方自列的已知问题。
6.4 金融、能源与行业纵深
金融:工商银行合作最深 。工行构建自主创新算力集群支撑"工银智涌"体系,与华为云联合落地金融业首个 Serverless NPU 弹性算力调度 (ModelArts 为核心、昇腾为底座):千亿 MoE 推理服务启动缩短至百秒级、效率提升 10 倍以上,DeepSeek-R1 满血版百秒内完成加载;生产上 7:00–23:00 跑推理、23:00–次日 7:00 跑风控训练,训推切换压缩至分钟级,节约 25% 算力资源 [42]。这是"降本"类数据中最具体的一条。能源电力:南方电网已进核心链路 。2026 年 WAIC 期间南方电网与华为发布《"大瓦特·知音"AI 能力平台构建与实践白皮书》,明确以昇腾智算集群为底座;已披露成效为服务用户超 2.7 亿、日承接服务请求 10 万余宗、关键场景智能化服务占比 89% [43]。制造、医疗、政务、教育 :制造侧可核实的仍是盘古"30 多个行业、400 多个场景"的覆盖统计;医疗侧为讯飞医疗与华西医院合作、北京联通门诊智能化方案在安徽/甘肃部署;政务侧以黑龙江"平台+大小模型算法+应用引擎"政务基座为代表;教育侧覆盖京鄂川多地校园、上万名师生。共同短板是只披露覆盖人数/地市数,不披露算力规模与付费金额 ,难以用于估算昇腾实际收入。
6.5 整机与生态伙伴:营收可查,专项数字稀缺 昇腾不自营品牌整机为主,出货高度依赖伙伴,因此伙伴财报是观察放量的窗口;但伙伴营收是公司总营收,不等于昇腾业务收入 。
伙伴 关键数字 口径/时间 来源 华鲲振宇(成都) 2024 年营收超 100 亿元;累计 30 万台服务器;600 余家伙伴 公司口径,2025-03;华为"鲲鹏+昇腾"双战略级伙伴 [51] 拓维信息(002261) 2025 年营收 31.71 亿元、归母净利 6374 万元(+163.43%);国产 AI 服务器出货 +120% 2025 年报 [52] 高新发展(000628) 2025 年营收 49.80 亿元;主营建筑施工 93.10%、功率半导体 1.20%、数字能源 2025 年报;未合并华鲲振宇 [53]
必须纠正一个市场误读 :高新发展 2025 年年报主营仅含建筑施工、功率半导体、数字能源,未将华鲲振宇纳入合并范围,前五大客户中 87.06% 为控股股东高投集团及子公司。"高新发展=华鲲振宇"的表述在 2025 年后已不成立,二级市场的"昇腾超节点"叙事缺少财报支撑 [53]。神州数码"2025 年 AI 服务器出货突破 10 万台"等说法源自自媒体,未获公告确认,本报告不予采信。
6.6 市场规模与份额:四套口径,趋势一致 机构/口径 统计对象 关键数据 发布日 IDC(媒体转述) 2025 年中国 AI 加速卡出货 总量约 400 万张;英伟达约 220 万张/55%;国产约 165 万张/41%;华为 81.2 万张/约 20% ;平头哥 26.5 万张;昆仑芯、寒武纪各约 11.6 万张 2026-04-02 [34] IDC(媒体转述) 2026H1 中国 AI 加速器出货 总量 200.8 万颗;英伟达 67.8 万/33.8%;华为 57.2 万/28.5% ;GPU 99.1 万(-26%)、非 GPU 101.6 万(+80%) 2026-10 [35][36] 科智咨询白皮书 2025 年中国 AI 加速卡 国产 165 万张、+65%、份额 41.3%;2026 年预计国产 230 万张、份额 51.1% 2026-07 TrendForce 中国 AI Server 芯片来源 外购英伟达/AMD 由 2024 年约 63% 降至 2025 年约 42%;本土芯片占比升至 40% 2025-05
三点判读 :其一,两套"41%"是同一趋势的两次测量而非同源,引用须分别标注;其二,2026 年"国产过半"是预测而非事实 ;其三,按量份额显著高于按额份额 ——昇腾单价与英伟达高端卡差距明显,按金额计算的国产份额必然更低。
6.7 性能、能效与降本:能说清的和说不清的
CloudMatrix 384 的系统级算力/内存/带宽倍数(SemiAnalysis)[14][15];
工行 Serverless NPU 的 25% 算力节约、百秒级启动 [42];
科大讯飞"业界 90% 以上"的性能(企业自述)[44];
清华计图 DeepSeek V2 推理提升 44.0%–90.3%(第三方学术)[45];
南方电网 2.7 亿用户、89% 智能化占比(客户生产数据)[43]。
没有任何公开可复现的昇腾万卡集群 MFU 数值 ;没有可信的"昇腾 vs 英伟达"全生命周期 TCO 量化报告 ,可引用的只有单点指标;"领先英伟达一代"是研究机构判断,不是标准基准测试;
各类"算力利用率 90%""训练效率 95%"的宣传数字,普遍缺少测试条件说明。
对读者的建议 :看到"昇腾训练效率达 XX%"时,先问三个问题——是 MFU 还是吞吐?是单机还是万卡?有没有第三方复现?三个问题答不上来的,按宣传数据打折处理。
第七章 未来趋势、挑战与情景推演
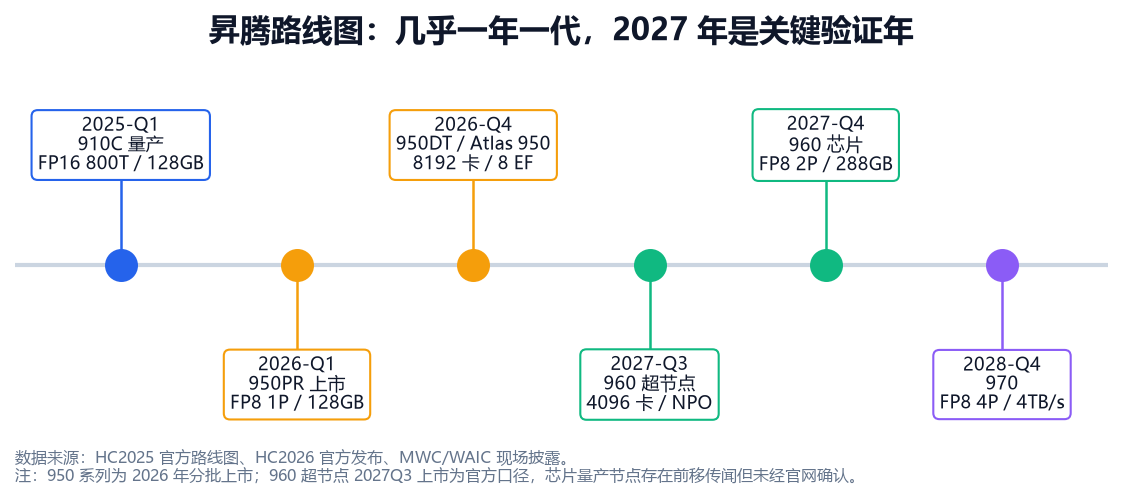
7.1 官方路线图与 2026–2028 节奏 时间 芯片 超节点/集群 关键指标 2025-Q1 910C 量产 Atlas 900 A3(CM384,384 卡) FP16 800 TFLOPS/卡;系统 300 PF BF16 2026-Q1 950PR Atlas 350 标卡、950 超节点服务器 FP8 1 PF、MXFP4 2 PF、2 TB/s 互联 2026-Q4 950DT Atlas 950 SuperPoD (8192 卡)、Atlas 950 SuperCluster(52 万卡)系统 FP8 8 EF/FP4 16 EF、1152 TB、16.3 PB/s 2027-Q3 960(提前) 昇腾 960 超节点 (4096 卡,NPO)系统 FP8 8 EF/FP4 16 EF,可用度 99.8% 2027-Q4 960 Atlas 960 SuperPoD(15488 卡)、Atlas 960 SuperCluster(百万卡) 芯片 FP8 2 PF/FP4 4 PF;系统 FP8 30 EF 2028-Q4 970 形态未公开 芯片 FP8 4 PF/FP4 8 PF、互联 4 TB/s
数据来源:HC2025 官方路线图 [1][2]、HC2026 官方发布 [3]、MWC/WAIC 现场披露 [22][30]。
图 5 昇腾路线图与关键时间节点。图表由点滴安全依据报告引用数据绘制。
节奏是真的在加快 。从"950PR 2026Q1 → 950DT 2026Q4 → 960 2027Q4"到"960 超节点 2027Q3 上市",说明华为在芯片流片与系统集成上比原计划更激进;但"发布"与"规模交付"之间仍有 6–12 个月时差(950PR 2026Q1 上市,至 2026Q4 仍是"量不算大")。每一代的核心卖点都在从"算力"转向"内存 + 互联" 。950 的代际差异主要是自研 HBM 与 2 TB/s 互联;960 的核心是 NPO 光引擎与 4096 卡域;970 的初步方向是 FP4/FP8 算力与互联带宽全面翻倍、内存带宽至少增 1.5 倍。2027 年是关键验证年 。960 超节点(2027Q3)与 Atlas 960 SuperPoD(2027Q4)能否按期,取决于:中芯国际 N+2/N+3 产能、自研 HBM 迭代(HiBL/HiZQ 之后的下一代)、Hi-ONE 光引擎量产良率。三者任一掉链子,路线图就会顺延。
7.2 六大趋势 趋势一:超节点 / Scale-up 域成为主战场。 2026 年国产超节点进入"商业化元年",已形成产品供给、公开采购、规模部署与云服务输出的完整链条。路线已出现分歧:华为、曙光、百度走 512–1024 卡"大节点",阿里、浪潮、沐曦坚持 64–128 卡更经济,清微走可重构数据流第三条路;本质是"时延敏感"与"内存池规模"的权衡,2027 年前难有定论 [33]。
趋势二:光互联从"可选"变"必选"。 华为选定 NPO 而非 CPO:Hi-ONE 模组 7.2 T 带宽、光引擎距芯片约 5 cm、成本较 CPO 低近 40%、可单独更换;昇腾 960 超节点用 5500 个 Hi-ONE 替代 48000 颗 800G 光模块,功耗降低超 550 kW [3][25]。当单域从 384 卡走向 8192/15488 卡,铜缆的物理极限使光互联成为唯一解。
趋势三:液冷成为高密度默认配置。 1024 卡超节点为 16 计算柜 + 4 交换柜、全液冷;昇腾 960 超节点采用正交架构 + 全液冷。但机房改造周期长、风冷 850E 仍有空间,液冷渗透会慢于芯片迭代 [21]。
趋势四:推理需求主导。 业内口径称线上推理与训练比接近 5:1 至 10:1,万卡集群中 70%–90% 做推理 [33]。这解释了华为"950PR 先出(Prefill/推荐)、950DT 后出(Decode/训练)"的产品排序,也解释了为什么 950 系列把 FP4/FP8 与内存访问粒度放在首位。
趋势五:低精度成为竞争焦点。 从 FP16→FP8→FP4 的演进正在重塑算力口径:950 系列新增 MXFP8/MXFP4 与自研 HiF8,950 白皮书称相比上代 BF16,MXFP4 张量浮点峰值算力提升最高达 4 倍;960 将支持自研 HiF4,华为称其为"目前业界最优的 4 bit 精度实现,比业界 FP4 方案推理精度更优" [2][19][20]。这意味着未来对比不能只看 FP16 峰值,低精度下的精度保持能力才是关键。
趋势六:"以系统补单芯" + 开源开放 + 政策加码。 徐直军明确"基于中国可获得的芯片制造工艺"构建超节点与集群;CANN/MindSpore/openEuler/openGauss 构成全栈开源;政策侧,"东数西算"正升级为全国统一算力网——彭博社报道中国拟五年投约 2 万亿元建全国数据中心、2028 年打通分散设施、至少 80% 关键技术依赖本土供应商(媒体引述知情人士,未见官方文件)[56]。
7.3 八项挑战:影响与观察指标 挑战 具体表现 影响 观察指标 先进制程与良率 主力仍依赖中芯 N+2(7nm 级);N+3(5nm 级)已在麒麟 9030 上量产,但 TechInsights 指其金属间距激进、良率承压、部分芯片降级使用 单卡算力与能效长期落后同期英伟达;晶圆成本高、供给弹性小 N+3 是否导入昇腾、月产能与良率披露 HBM 供应 自研 HiBL 1.0/HiZQ 2.0 已上机,但 2024 年 12 月美对华先进 HBM 管制后正规渠道受阻;HBM 占加速卡成本大头 推高成本、拉长交期、限制出货量 自研 HBM 代际迭代、容量配置(96 GB 选配) 功耗与散热 Atlas 350 单卡 600 W(H20 的 1.5 倍);1024 卡超节点全液冷;CM384 功耗约为 NVL72 的 4.1 倍 存量风冷机房难承载;PUE 与电费侵蚀 TCO 全液冷渗透率、每 Token 电费 万卡以上集群稳定性 徐直军称真正挑战是"让数千、数万颗处理器组成一台计算机";25.6 万卡在部署测试;CANN 自列跨超场景 sendrecv 卡死问题 规模越大 MFU 越低、训练中断风险越高 第三方 MFU、长稳测试时长、断点续训效率 软件生态与 CUDA 护城河 CANN 开源仅一年多,算子覆盖与工具链成熟度仍逊于 CUDA;国内分"CUDA 兼容"与"自研生态"两派 迁移成本高、模型适配周期长、客户担心锁定 主流模型 Day-0 数量、vLLM-Ascend 已知问题收敛速度 成本与价格 2026 年 9 月 HBM 短缺推动涨价:950DT 逾 25 万元、较两个月前涨 20%–50%;950PR 由约 6 万涨至逾 8 万元;910C 由约 9 万涨至逾 11 万元;寒武纪、沐曦、天数同步提价 20%–30% 智算中心单位算力投资上升,租赁回报周期承压 单卡报价、交付周期、租赁价格 美国出口管制与实体清单 2019 年实体清单、2020 年 FDPR;2025 年起美方称全球使用昇腾芯片违规;2026 年 7 月 FCC 新规、10 月 13 日生效,10 月 22 日首次按"含逻辑处理能力的硬件组件"拦截海思芯片设备;约 60 万块 H200 滞留香港 海外市场基本关闭(华为称无全面出海计划);设备与零部件合规风险外溢 规则是否延伸至 AI 加速卡整机与第三国 国内竞争 2026H1 国产阵营内部华为占 52%,平头哥/寒武纪/昆仑芯/海光合计 34.6%,6 家第三梯队合计 13.3% 价格战与产能、人才争夺;客户多供策略削弱华为份额上限 寒武纪 690、昆仑芯、曙光/百度超节点进度
数据来源:制程 [54]、HBM 与涨价 [49]、功耗 [23]、稳定性 [8][25]、生态 [7][10][31]、管制 [54][55]、竞争 [35][36][37]、集群 [33]。
制程与 HBM 是"硬约束",其余是"软约束"。 单卡算力受制程限制已是公开事实,华为的解法是把竞争维度换成"卡数 × 互联带宽 × 内存池":8192 卡、16.3 PB/s、1152 TB 正是这一思路的产物。代价是对 HBM、光模块、液冷、供电的高度依赖,任何一环短缺都会转化为交付延期与涨价——2026 年涨价潮即是明证。
生态与管制是更长周期变量。 CANN 开源快,但"能用"与"好用"仍有距离;国内路线分裂(CUDA 兼容 vs 自研生态)又分散投入。管制侧,2026 年 10 月 FCC 首次依据"逻辑承载硬件"新规拦截含海思芯片的设备,标志管制节点从整机下沉到零部件;同期 60 万块 H200 滞留香港,说明中国对英伟达高端卡的进口审批本身也成了变量 [54][55]。
7.4 2027 年情景推演 情景 触发条件 可能结果 概率判断 乐观 960 超节点按期 2027Q3 上市;自研 HBM 迭代顺利;950DT 规模交付;CANN 生态跨过"好用"拐点 昇腾在中国推理市场份额超 40%、训练侧拿下国产替代主份额;Atlas 960 SuperCluster 成为万亿参数模型主力底座 25% 基准 950DT 交付延迟 1–2 个季度;960 超节点 2027H2 小批量;HBM 与光模块仍是瓶颈 昇腾守住国产第一(份额 30%–35%),但"高端 90%"落空;训练侧仍以英伟达存量 + 昇腾混合为主 50% 悲观 制程或 HBM 被进一步卡死;涨价失控;CANN 生态因路线分裂而碎片化;国产同行分流 昇腾退守推理与政企市场,训练侧被寒武纪/昆仑芯/英伟达特供分流;超节点叙事降温 25%
本报告基准判断 :2027 年昇腾在中国 AI 加速卡市场按出货量的份额落在 30%–40% ,按金额可能更高;推理侧主导地位基本确立,训练侧的胜负取决于 950DT/960 的实际交付量与第三方 MFU 数据——这两项数据在 2026 年 11 月仍然缺失,是判断昇腾长期竞争力的最大信息缺口。
7.5 对不同读者的建议
企业与机构 IT 决策者 :把昇腾当作"可用的第二供应源"而非"廉价的英伟达替代"。推理场景可优先迁移(vLLM-Ascend 成熟度最高);训练场景建议先做 1–2 个模型的端到端验证,把算子重写与精度对齐的工作量计入预算。开发者 :优先掌握 Ascend C 与图模式调优,而不是只学 torch_npu 的 import 替换;关注 vLLM-Ascend 的 release notes(官方自列的已知问题是最好的学习材料)。投资者 :区分"发布"与"交付"、"出货量份额"与"收入份额"、"系统级指标"与"单卡指标";重点跟踪 950DT 的规模交付、自研 HBM 良率、CANN 生态的外部贡献者占比。政策制定者 :国产化率指标应配套"有效算力"与"能效"考核,避免只考核卡数;对 CANN 这类"源码开放但非 OSI 开源"的基础软件,需在采购与安全审查中明确其许可边界。
第八章 结论
昇腾已从"单点芯片"进化为"芯片—互联—整机—软件"的完整体系。 自 2019 年昇腾 910 发布以来,七年时间形成了 310/610/910/950/960/970 的完整谱系,以及 Atlas 整机、CloudMatrix/Atlas 超节点、灵衢 UB、Hi-ONE 光引擎、CANN/MindSpore 软件栈的全栈能力 [69]。在国内,它是唯一具备"定义互联协议 + 自研 HBM + 自研编译器"的 AI 芯片厂商。
单卡落后是事实,系统级反超也是事实。 910C 的 BF16 稠密算力约为 H100 的 0.8 倍、B200 的 1/3;但 CloudMatrix 384 用 384 颗芯片做到约 300 PFLOPS,约为 GB200 NVL72 的 1.6–2 倍;Atlas 950 SuperPoD 把域扩到 8192 卡、内存 1152 TB、互联 16.3 PB/s。这是一条"以规模、功耗与工程复杂度换制程差距"的路线,其可持续性取决于光互联成本曲线与国产 HBM 爬坡。
软件栈跨过了"可用"拐点,尚未跨过"好用"拐点。 400 万开发者、3000+ 合作伙伴、60+ 伙伴自研 420+ 算子、主流模型 Day-0 适配、vLLM-Ascend 与上游 main2main 对齐——这些都是真实进展。但"源码开放但非 OSI 开源"的许可证、算子级重写成本、图模式调优门槛、通信库稳定性问题,决定了迁移成本仍是客户的第一道门槛。
产业落地已"基础设施化",但数据质量参差。 三大运营商近 6 万卡、工行 25% 算力节约、南网 2.7 亿用户、讯飞万卡平台,构成可信的落地证据链;但"万卡 MFU""TCO 对比""训练效率 XX%"普遍缺少可复现口径。2025 年华为 81.2 万张、约 20% 份额;2026H1 升至 28.5%——量的拐点已过,质的验证才刚开始。
未来 18 个月的关键变量是供给,不是架构。 制程良率、自研 HBM 爬坡、光模块与液冷供给决定 950 系列能交多少;HBM 短缺已推动 950DT 涨至逾 25 万元。2027 年昇腾大概率守住中国推理市场的主导地位(出货份额 30%–40%),训练侧能否替代英伟达,取决于 950DT/960 的交付与第三方 MFU 数据——这是本报告留给读者的、最值得持续跟踪的一个问题。
附录 A 关键数据速查 指标 数值 口径 910C 单卡 FP16 800 TFLOPS 官方,稠密 910C HBM 128 GB / 3.2 TB/s 官方 CM384 系统算力 约 300 PFLOPS BF16 第三方测算(SemiAnalysis) CM384 部署量 1000+ 套(2026-10) 徐直军口径 950PR 单卡 FP8/FP4 1 PF / 2 PF(MXFP4) 官方路线图 950PR 标卡(Atlas 350) 112 GB / 1.4 TB/s / 600 W / FP4 1.56 PF 展台口径 950DT 单卡内存 144 GB / 4 TB/s 官方 Atlas 950 SuperPoD 8192 卡、8 EF FP8、1152 TB、16.3 PB/s 官方 昇腾 960 超节点 4096 卡、8 EF FP8、2027Q3 官方 2025 中国 AI 加速卡出货 约 400 万张,国产 41%,华为 20% IDC(媒体转述) 2026H1 中国 AI 加速器出货 200.8 万颗,英伟达 33.8%,华为 28.5% IDC(媒体转述) CANN 最新版本 9.2.x(2026-10) 官方 release notes 昇腾开发者 400 万+(2025 年底) 官方 中国 AI 芯片市场规模预测 2026 年出货 +19%(GPU -9%) IDC
附录 B 缩略语 缩略语 全称 含义 CANN Compute Architecture for Neural Networks 昇腾异构计算架构 CM384 CloudMatrix 384 华为 384 卡超节点 HCCS Huawei Cache Coherence System 昇腾卡间互联 UB / UBoE UnifiedBus / UB over Ethernet 灵衢互联协议 / 承载于以太网 NPO / CPO Near-Packaged Optics / Co-Packaged Optics 近封装光 / 共封装光 HBM High Bandwidth Memory 高带宽内存 MFU Model FLOPs Utilization 模型算力利用率 TPS Tokens Per Second 每秒生成 token 数 MoE Mixture of Experts 混合专家模型 PD 分离 Prefill-Decode Disaggregation 预填充与解码分离部署 LPO Linear-drive Pluggable Optics 线性直驱可插拔光模块 TCO Total Cost of Ownership 总拥有成本
图表索引 图 内容 数据口径 图 1 昇腾单卡算力演进 官方路线图 + 910B 按核数推算的社区口径;稠密峰值 图 2 中国 AI 加速卡出货份额 IDC 数据经媒体转述;2025 全年与 2026H1 图 3 CloudMatrix 384 vs GB200 NVL72 SemiAnalysis 系统级测算;非标准基准测试 图 4 Atlas 950 SuperPoD vs NVL144 华为官方口径,NVL144 数值按官方倍数反推 图 5 昇腾路线图与时间节点 HC2025/HC2026 官方发布与现场披露
图表均为本站依据公开数据自行绘制,采用统一视觉规范;如发现数据口径问题,欢迎通过 举报与投诉 反馈。
合规与转载说明
信息性质 :本文为公开信息整合与独立分析,不代表华为或任何被提及企业的官方立场;文中"领先/落后"等判断均为基于公开数据的分析结论。数据口径 :所有关键数字均标注来源与口径(单卡/整机/系统、稠密/稀疏、官方/第三方)。引用本文数据时请保留限定词,避免断章取义。存疑标注 :对未获官方确认的规格、传闻型号(如 910D)、未公开的良率与产能,正文已明确标注"存疑/未证实",不作为事实依据。版权 :正文为本站整理与原创分析,图表为本站自绘;欢迎转载,请注明"来源:点滴安全(dripsafe.cn)"并保留原文链接。第三方商标与产品名称归其权利人所有。纠错 :如发现事实或数据错误,可通过 举报与投诉 联系我们,核实后更正。
参考文献
说明:参考文献按类别编号,正文以 [n] 标注。A 类为华为/昇腾官方一手来源,B 类为权威第三方研究、媒体与上市公司公告,C 类为社区/开源项目。所有链接均为检索时实际访问或经交叉核验的地址;数据口径以正文标注为准。
A 类:华为 / 昇腾官方一手来源 [1] 华为.《Huawei Unveils World's Most Powerful SuperPoDs and SuperClusters》(HC2025 新闻稿). 2025-09-18. 原文链接
[2] C114 通信网.《华为徐直军公开昇腾芯片、超节点等新品路标及时间表》(演讲全文). 2025-09-18. 原文链接
[3] 华为.《华为发布全球首个采用 NPO 的超节点——昇腾 960 超节点》(HC2026 新闻稿). 2026-09-17. 原文链接
[4] 华为.《全面开源开放,共赢昇腾生态》. 2025-09-20. 原文链接
[5] 昇腾社区.《Atlas 300I Pro 推理卡介绍》(产品文档). 原文链接
[6] 昇腾社区.《Atlas 200I DK A2 Specifications》(官方规格页). 原文链接
[7] CANN 社区.《CANN 9.1.0 版本说明》. 原文链接
[8] CANN 社区.《CANN 9.0.0 版本说明》. 原文链接
[9] 华为.《CANN Open Software License Agreement Version 2.0》(ops-nn 仓库 LICENSE). 原文链接
[10] Ascend.《TorchNPU 26.1.0 版本说明》. 2026-07. 原文链接
[11] vLLM Ascend.《vLLM Ascend Release Notes v0.30.0》. 2026-10-29. 原文链接
[12] 昇腾社区.《昇思 MindSpore 2.8 版本正式发布》. 2026-01-29. 原文链接
[13] 昇腾社区.《昇腾 CANN 8.0 正式发布,多项核心技术引领大模型原生创新》. 2024-10-17. 原文链接
[16] CANN 社区.《NPU 硬件参数真值参考》(platform_config INI 字段整理). 原文链接
[17] CANN 社区.《昇腾硬件架构与 SHMEM 约束》. 原文链接
[65] 昇腾社区.《CANN 8.3.RC1 开发文档》. 原文链接
[69] 央广网.《华为正式发布最新 AI 处理器昇腾 910 及全场景 AI 计算框架 MindSpore》. 2019-08-23. 原文链接
B 类:权威第三方研究、媒体与上市公司公告 [14] SemiAnalysis (Dylan Patel et al.). "Huawei AI CloudMatrix 384: China's Answer to NVIDIA GB200 NVL72". 2025-04-16. 原文链接
[15] 人民网.《知名半导体研究机构:华为云 CloudMatrix 384 可满足超大规模 AI 计算需求》. 2025-04-19. 原文链接
[18] 芯东西.《华为曝 AI 芯片大招,搭载自研 HBM!全球最强算力超节点和集群赢麻了》. 2025-09-18. 原文链接
[19] 电子工程专辑.《超越 NVIDIA!华为昇腾 950/960/970 全公布 首次搭载自研 HBM 内存》. 2025-09-18. 原文链接
[20] 电子工程专辑.《华为昇腾 950 白皮书公布:自研 144GB 高速内存、4 倍性能提升》. 2026-06-12. 原文链接
[21] 南方都市报.《华为将于今年四季度上市两款智算超节点,参数规格揭晓》. 2026-05-22. 原文链接
[22] 观察者网.《满配 8192 张昇腾卡,华为首次在海外展示全球最强超节点》(MWC 2026). 2026-03-01. 原文链接
[23] 央广网/上海证券报.《华为重磅发布新一代算力芯片》(华为中国合作伙伴大会 2026). 2026-03-22. 原文链接
[24] IT之家.《华为 Atlas 350 加速卡上市,搭载全新昇腾 950PR 处理器》. 2026-03-21. 原文链接
[25] 科创板日报/电子工程专辑.《徐直军:华为昇腾已超过英伟达!》(HC2026 媒体问答). 2026-10-06. 原文链接
[26] TrendForce. "Huawei Says Ascend Market Share Tops NVIDIA in China, Backs NPO Over CPO for Optical Interconnects". 2026-10-07. 原文链接
[27] MirrorFrog AI 算力卡百科.《Huawei Ascend 910C》(汇总官方发布会与百科口径). 原文链接
[28] 科技日报(崔爽).《昇腾 CANN 完成开源开放》. 2026-02-13. 原文链接
[29] 新浪科技.《华为公布昇腾 AI 生态进展:开发者数量 400 万+,发展合作伙伴 3000+》. 2026-01-09. 原文链接
[30] LightCounting. "July 2026 Atlas 950 SuperPoD: Achieves All-Optical Interconnection with Superior Cost and Power Efficiency"(WAIC 2026 现场分析). 2026-07-21. 原文链接
[33] 36 氪/数智前线.《2026 年下半年,算力竞赛为何突然转向超节点?》. 2026-07-27. 原文链接
[34] 电子工程专辑(飙叔科技洞察).《400 万张!华为出货 81.2 万张,国产 AI 芯片占据 41%》(转述 IDC 2025 全年数据). 2026-04-02. 原文链接
[35] DigitalToday(转述 IDC 2026H1 数据).《IDC:NVIDIA 上半年中国 AI 加速器出货量下滑 44%,Huawei 份额升至 28%》. 2026-10-14. 原文链接
[36] OFweek 电子工程网(转述 IDC 2026H1 数据).《中国 AI 芯片:英伟达份额 33.8% 排第 1,华为第 2,寒武纪第 4》. 2026-10-16. 原文链接
[37] 国际电子商情.《英伟达中国份额仅剩 8%?2026 年国产 AI 芯片将拿下 90% 高端市场》(引 TrendForce、Bernstein、IDC、路透). 2026-08-13. 原文链接
[38] 第一财经(樊雪寒).《中国移动建成全球运营商最大单体智算中心》. 2024-04-28. 原文链接
[39] 人民日报海外版(崔佳、方圆).《超万卡集群让算力迈上新台阶》. 2024-10-18. 原文链接
[40] 天翼云.《全国首个国产单池万卡液冷算力集群正式启用,天翼云以科技创新加速算力普惠》. 2024-03-23. 原文链接
[41] 央广网(万玉航).《华为云公布 AI 基础设施架构突破性新进展 CloudMatrix 384 超节点已规模上线》. 2025-04-10. 原文链接
[42] 赛迪网.《华为云携手工商银行落地金融业首个 Serverless NPU 弹性算力调度技术》. 2025-12-02. 原文链接
[43] 中国能源新闻网(苏立伟).《南方电网联合华为发布"大瓦特·知音"AI 白皮书》. 2026-07-24. 原文链接
[44] 中国财富网.《科大讯飞与华为实践证明:基于昇腾算力打造自主可控通用大模型底座是完全可行的》. 2024-09-22. 原文链接
[45] 清华大学计算机科学与技术系.《清华大学计算机系计图团队实现华为昇腾上 DeepSeek 模型的适配和高效推理》. 2025-04-24. 原文链接
[46] 瞭望(张翊飞).《国产算力突围重塑产业竞争逻辑》. 2026-05-08. 原文链接
[47] IT之家.《华为昇腾 0 Day 支持智谱 GLM-5.2 模型,提供全面推理优化》. 2026-06-18. 原文链接
[48] 搜狐(IT 之家转载).《阶跃星辰开源 Step 5 Preview 权重,华为昇腾、沐曦、壁仞首发支持》. 2026. 原文链接
[49] 路透社报道(网易转载).《高带宽内存短缺冲击供应链 中国本土 AI 芯片厂商集体大幅上调加速卡售价》. 2026-09-10. 原文链接
[50] 证券时报.《灵衢首批合作伙伴正式签约》. 2026-05-31. 原文链接
[51] 人民网四川频道/成都日报(蔡宇).《自主创"芯" 锻造"硬核"实力》. 2025-03-10. 原文链接
[52] 新华财经(陈冉、李晓雪).《净利大增超 160% 拓维信息持续深化"AI+鸿蒙"》. 2026-05-20. 原文链接
[53] 成都高新发展股份有限公司.《2025 年年度报告》. 2026-04-28. 原文链接
[54] 观察者网/澎湃新闻.《美国首次动用新规,搭载海思芯片的设备被拦截》. 2026-10-23. 原文链接
[55] 大公文汇网.《60 万块英伟达 H200 芯片在香港等待批准进口 外交部回应》. 2026-11-09. 原文链接
[56] 联合早报.《未来五年投 2 万亿人民币 中国在全国建数据中心》(引述彭博社). 2026-06-10. 原文链接
[57] NVIDIA Blog (Shruti Koparkar). "Fastest, Largest, Strongest: NVIDIA Blackwell Sweeps MLPerf Training 6.0". 2026-06-16. 原文链接
[58] Introl Solutions.《NVIDIA Blackwell Ultra 和 B300:下一代 GPU 的基础设施需求》. 2026-02-02. 原文链接
[59] AMD.《AMD Instinct MI355X》官方规格页. 原文链接
[60] Google Cloud.《TPU7x (Ironwood) 官方文档》. 访问于 2026-11-10. 原文链接
[61] 快科技.《谷歌推出第八代 TPU:最高提升 2.8 倍 训练推理首次拆分》. 2026-04-23. 原文链接
[62] 电子技术应用(C114).《亚马逊发布新一代自研 AI 芯片 Trainium3》. 2025-12-03. 原文链接
[63] 国海证券.《寒武纪(688256)2026 年三季报点评:盈利能力持续亮眼 思元 690 量产有望成为新核心引擎》. 2026-11-01. 原文链接
[64] 电子工程专辑.《国产 GPU 四小龙之一沐曦首次盈利:7nm 显卡已量产》. 2026-08-31. 原文链接
[67] MindSpore 社区.《昇思 MindSpore 2.7 版本首发"焕新社区"》. 2025-07-27. 原文链接
[68] 科技日报(颉满斌).《甘肃庆阳算力规模突破 30 万 P》. 2026-10-21. 原文链接
[70] 财联社.《中国移动将商用三个自主可控万卡集群 总规模近 6 万张 AI 加速卡》. 2024-04-28. 原文链接
C 类:社区 / 开源项目 [31] verl 社区.《模型迁移至 NPU 指南》. 最后更新 2026-05-14. 原文链接
[32] SLAI-AscendBridge.《基于 Hugging Face Transformers 的昇腾 NPU 适配验证项目》. 原文链接
[66] vLLM Ascend.《支持模型矩阵(v0.11.0)》. 原文链接
免责声明 :本报告基于截至 2026 年 11 月 10 日的公开信息编制,所有数据均标注来源与口径。涉及未公开的芯片制程、良率、产能与财务数据,本报告仅作定性判断并明确标注"未证实"。报告不构成投资建议;引用本报告数据时,请保留"单卡/系统""稠密/稀疏""官方/第三方"等限定词,以免误读。
Agent 权限设计的 5 条最小权限原则